[만화][AI] 같은 질문인데 AI는 왜 답이 매번 다를까? (확률과 온도)
여러분 혹시 ChatGPT나 Claude한테 같은 질문을 두 번 해 본 적 있나요?
'다시 생성'을 누르면 답이 바뀝니다. 이름 짓기 같은 질문이면 오히려 재밌죠. 근데 뭘 살지 물어봤는데 답이 뒤집히면 좀 당황스럽습니다.
쪼덕이가 딱 그랬습니다.
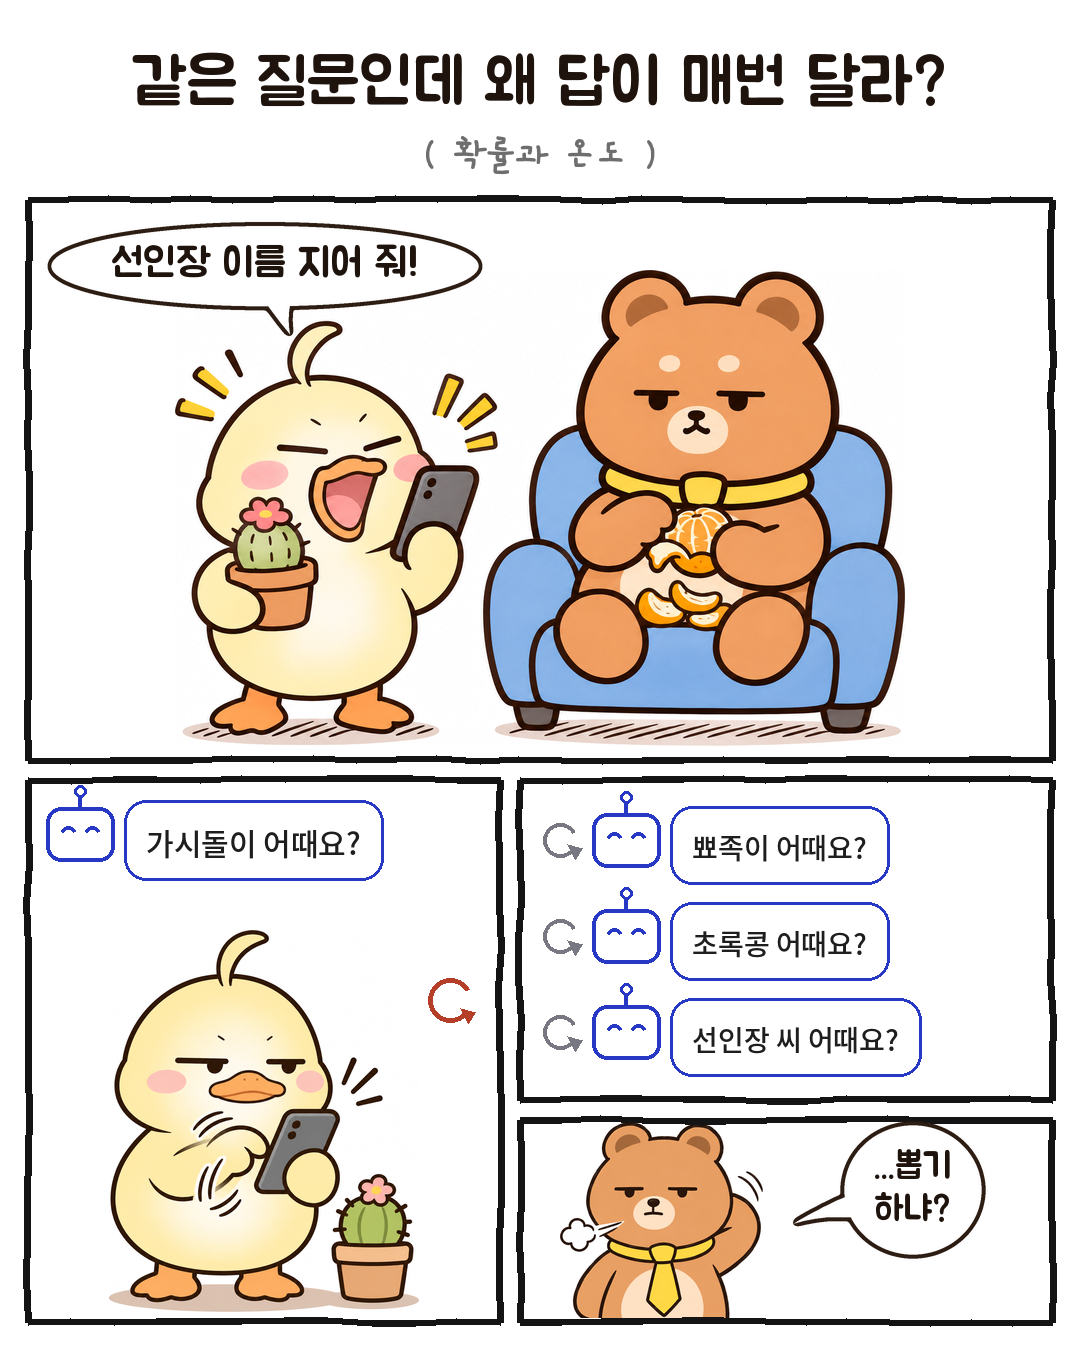
시작은 선인장 이름이었습니다. "가시돌이", 다시 누르니 "뾰족이", 또 누르니 "초록콩", "선인장 씨". 여기까지는 웃고 넘겼는데요.
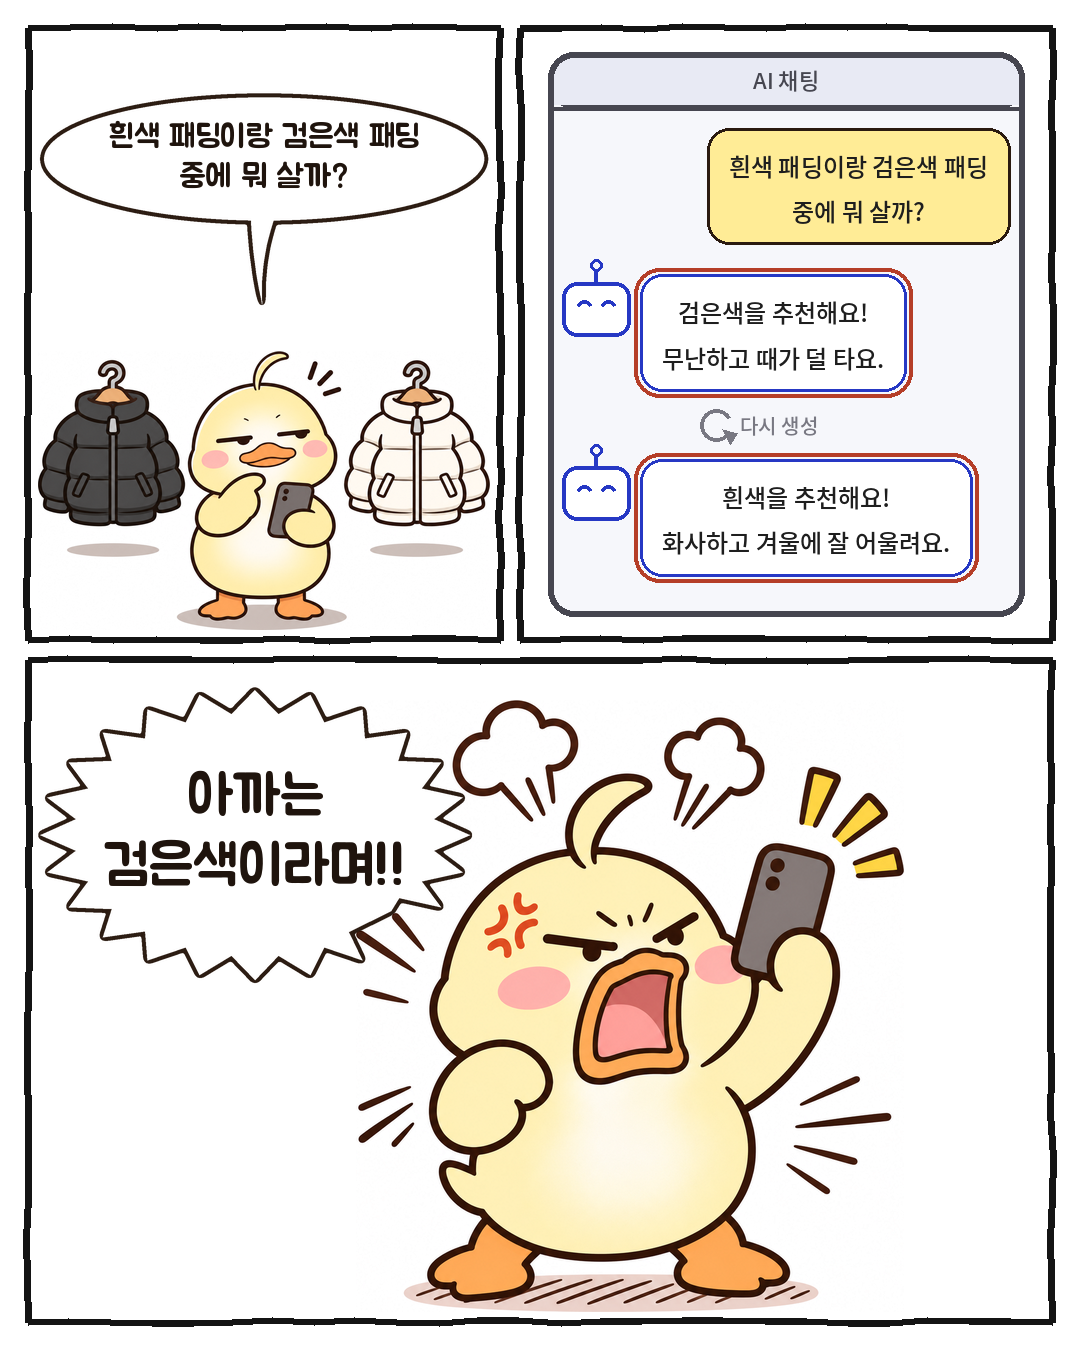
쪼덕: 흰색 패딩이랑 검은색 패딩 중에 뭐 살까?
처음 답은 "검은색을 추천해요! 무난하고 때가 덜 타요." 다시 생성하니 "흰색을 추천해요! 화사하고 겨울에 잘 어울려요."
쪼덕: 아까는 검은색이라며!!
AI가 변덕을 부리는 걸까요? 사실 AI가 답을 만드는 방식 안에 원래 '뽑기'가 들어 있습니다.
1. AI는 답을 어떻게 고를까?
1-1. 다음 조각을 하나씩 고른다
AI는 답 전체를 한 번에 떠올리지 않습니다. 지금까지 쓴 글을 보고, 바로 다음에 올 조각 하나를 고릅니다. 붙이고, 또 다음 조각을 고르고. 답이 끝날 때까지 이걸 되풀이합니다.
이 조각이 1화에서 나온 토큰(Token)입니다. 단어 하나일 때도 있고, 단어의 일부일 때도 있습니다.
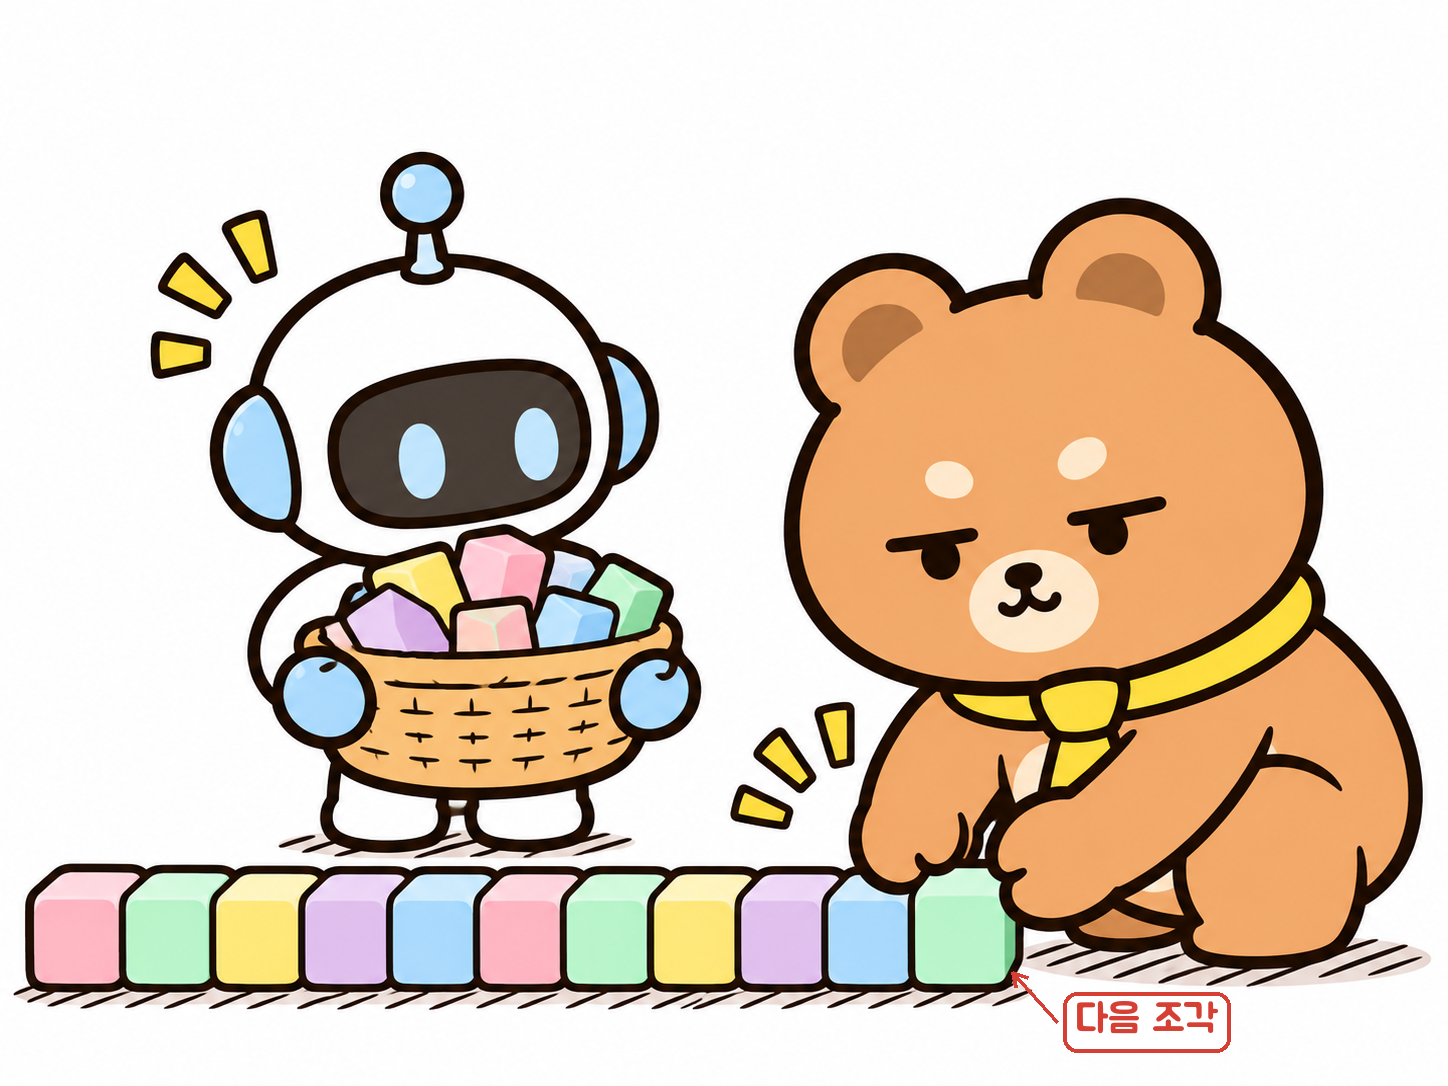

휴대폰 자판 추천 단어를 생각하면 쉽습니다. "오늘 점심은"까지 치면 위에 [짜장면] [김치찌개] [초밥]이 뜨잖아요. AI도 비슷한 걸 합니다. 후보가 세 개가 아니라 수만 개라는 것만 다릅니다.
쪼덕: 조각?
문곰: 응. 글자 조각. 1화에서 했잖아.
1-2. 후보마다 확률이 붙는다
AI는 후보마다 점수를 매기고, 그 점수를 확률로 바꿉니다. "오늘 점심은" 다음이라면 대충 이런 모양입니다.
다음 후보 확률
| 짜장면 | 50% |
| 김치찌개 | 35% |
| 초밥 | 15% |
* 숫자는 이해를 돕기 위한 예시입니다.
음식 이름 전체를 후보 하나로 표시했지만, 실제로는 더 작은 토큰으로 나뉠 수 있습니다.
1-3. 그리고 룰렛을 돌린다
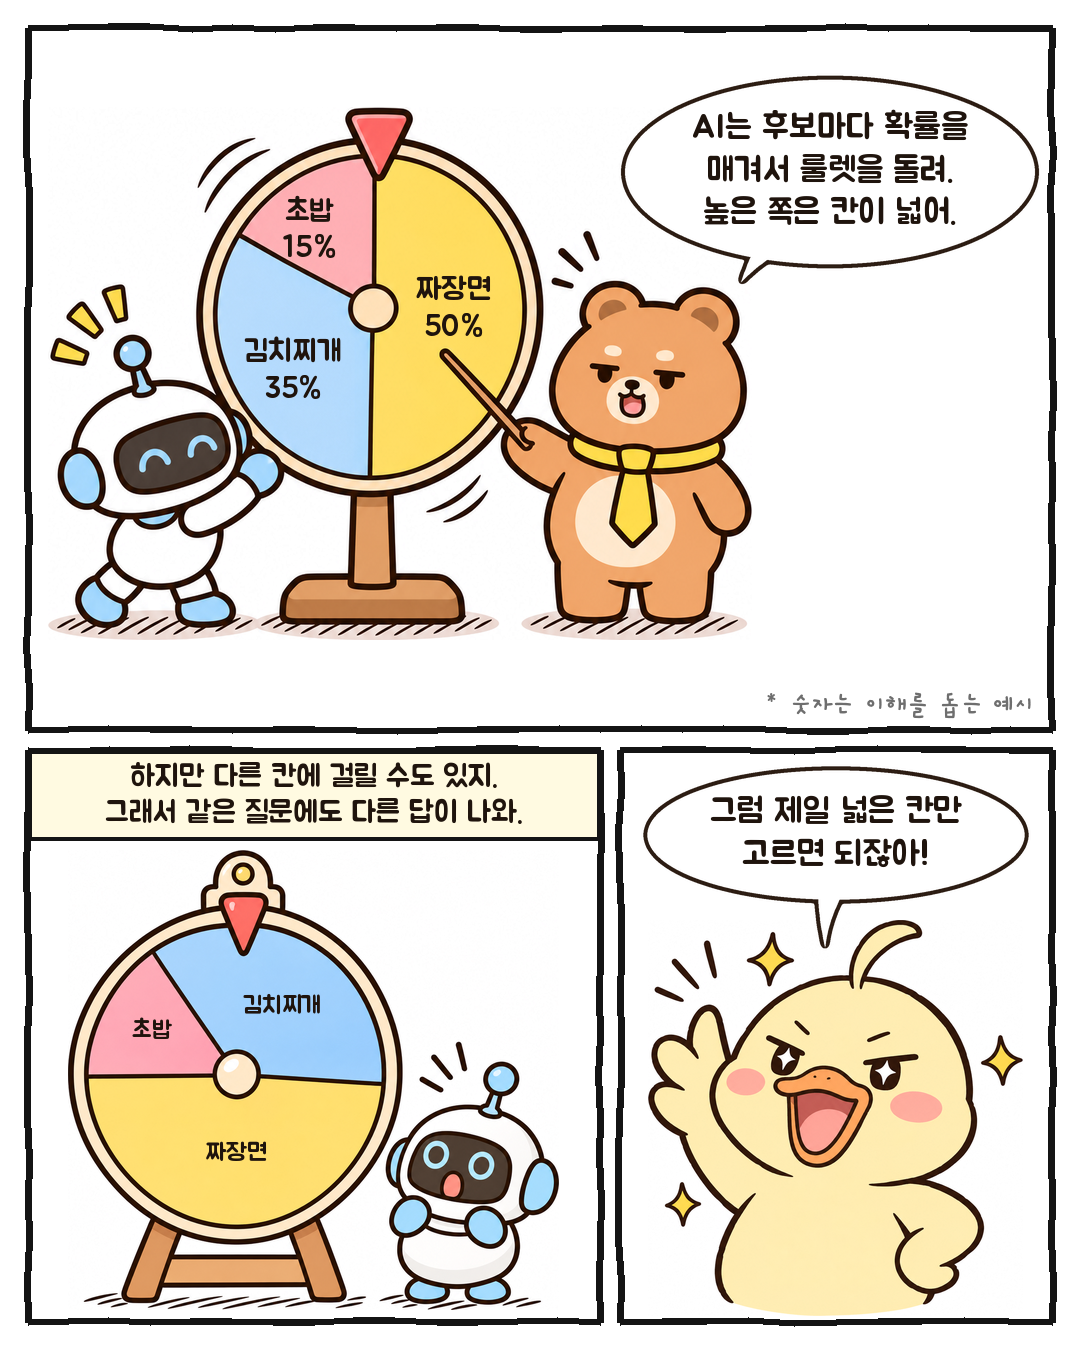
확률이 정해졌다고 매번 1등이 뽑히진 않습니다. 확률만큼 칸을 나눈 룰렛을 돌려서 고르거든요. 이걸 샘플링(Sampling)이라고 합니다.
짜장면 칸이 제일 넓으니 자주 걸리긴 합니다. 그래도 열 번 돌리면 김치찌개가 서너 번, 초밥도 한두 번쯤 나올 수 있습니다.
'다시 생성'은 이 룰렛을 처음부터 다시 돌리는 버튼입니다. 같은 질문에 답이 달라지는 건 그래서예요.
문곰: 뽑기 맞아. 칸 크기가 다를 뿐이지.
2. 제일 넓은 칸만 고르면 안 될까?
2-1. 늘 1등만 고르면
쪼덕: 그럼 제일 넓은 칸만 고르면 되잖아!
실제로 그렇게 하는 방식도 있습니다. 매번 확률 1등만 고르는 방식이고, 탐욕적 디코딩(Greedy Decoding)이라고 부릅니다.
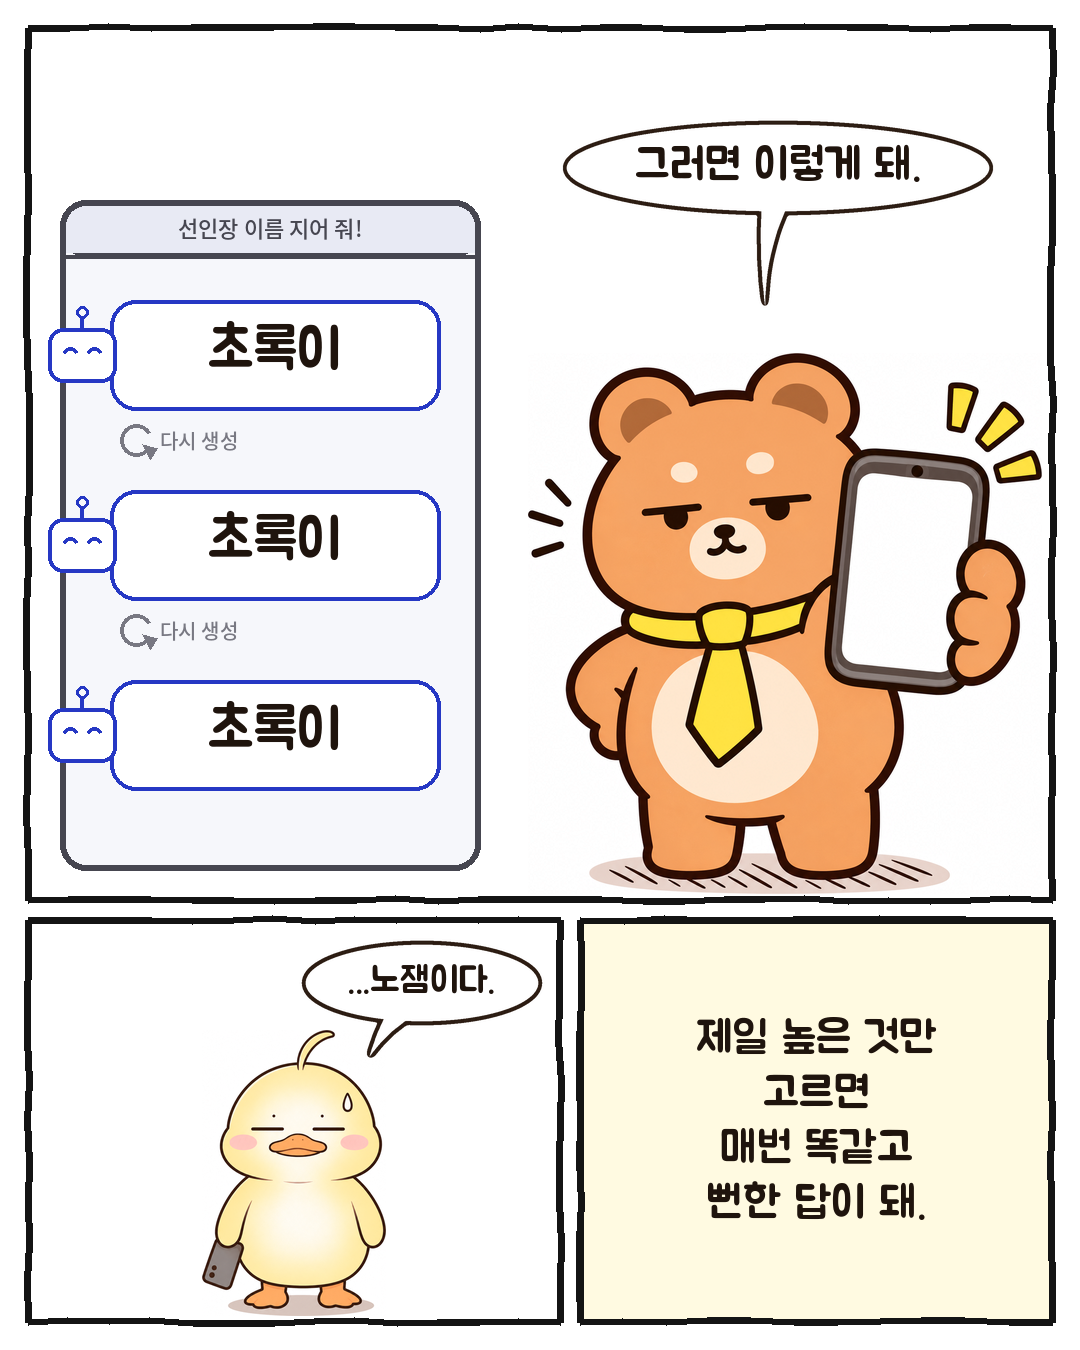
문제는 재미가 없다는 겁니다. 선인장 이름을 세 번 물어봐도 "초록이", "초록이", "초록이".
쪼덕: ...노잼이다.
만화라서 과장한 것 같지만, 연구로도 확인된 얘기입니다. 2020년 워싱턴대 연구팀은 확률 높은 쪽만 고르면 글이 밋밋해지고 같은 말을 되풀이하기 쉽다고 보고했습니다[1]. 사람이 쓴 글은 반대로 단어마다 확률이 높았다 낮았다 들쭉날쭉했고요. 생각해 보면 매번 제일 뻔한 단어만 골라 말하는 사람은 없으니까요.
그래서 채팅 AI는 보통 룰렛을 돌립니다. 답이 매번 바뀌는 건 글을 덜 뻔하게 만들려고 일부러 남겨 둔 거예요.
2-2. 룰렛 칸을 조절하는 손잡이, 온도(Temperature)
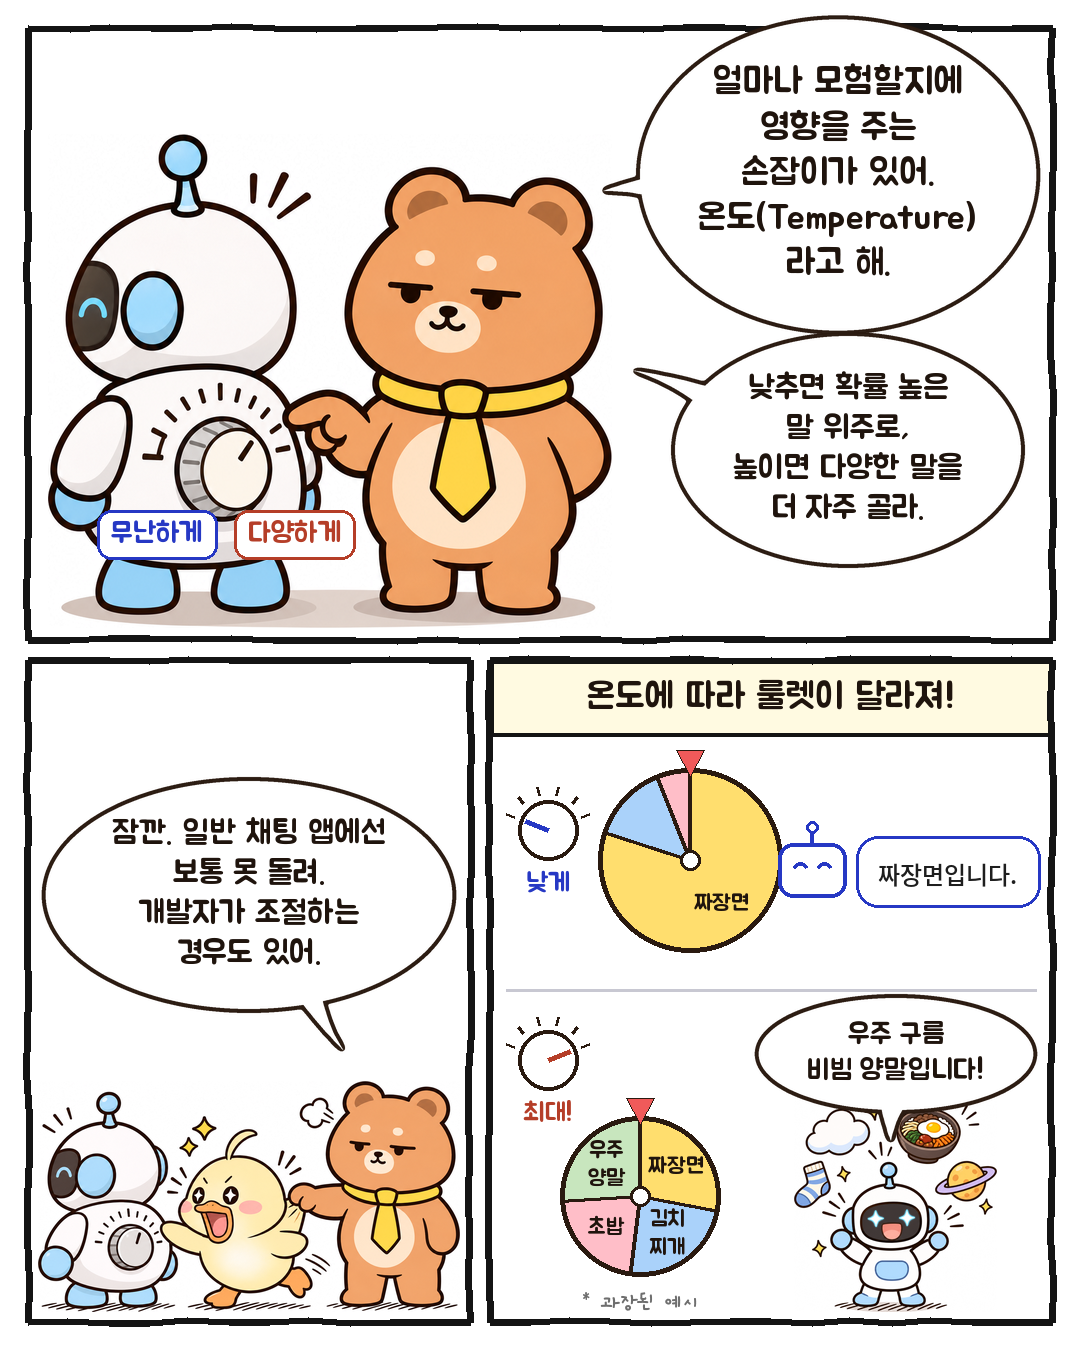
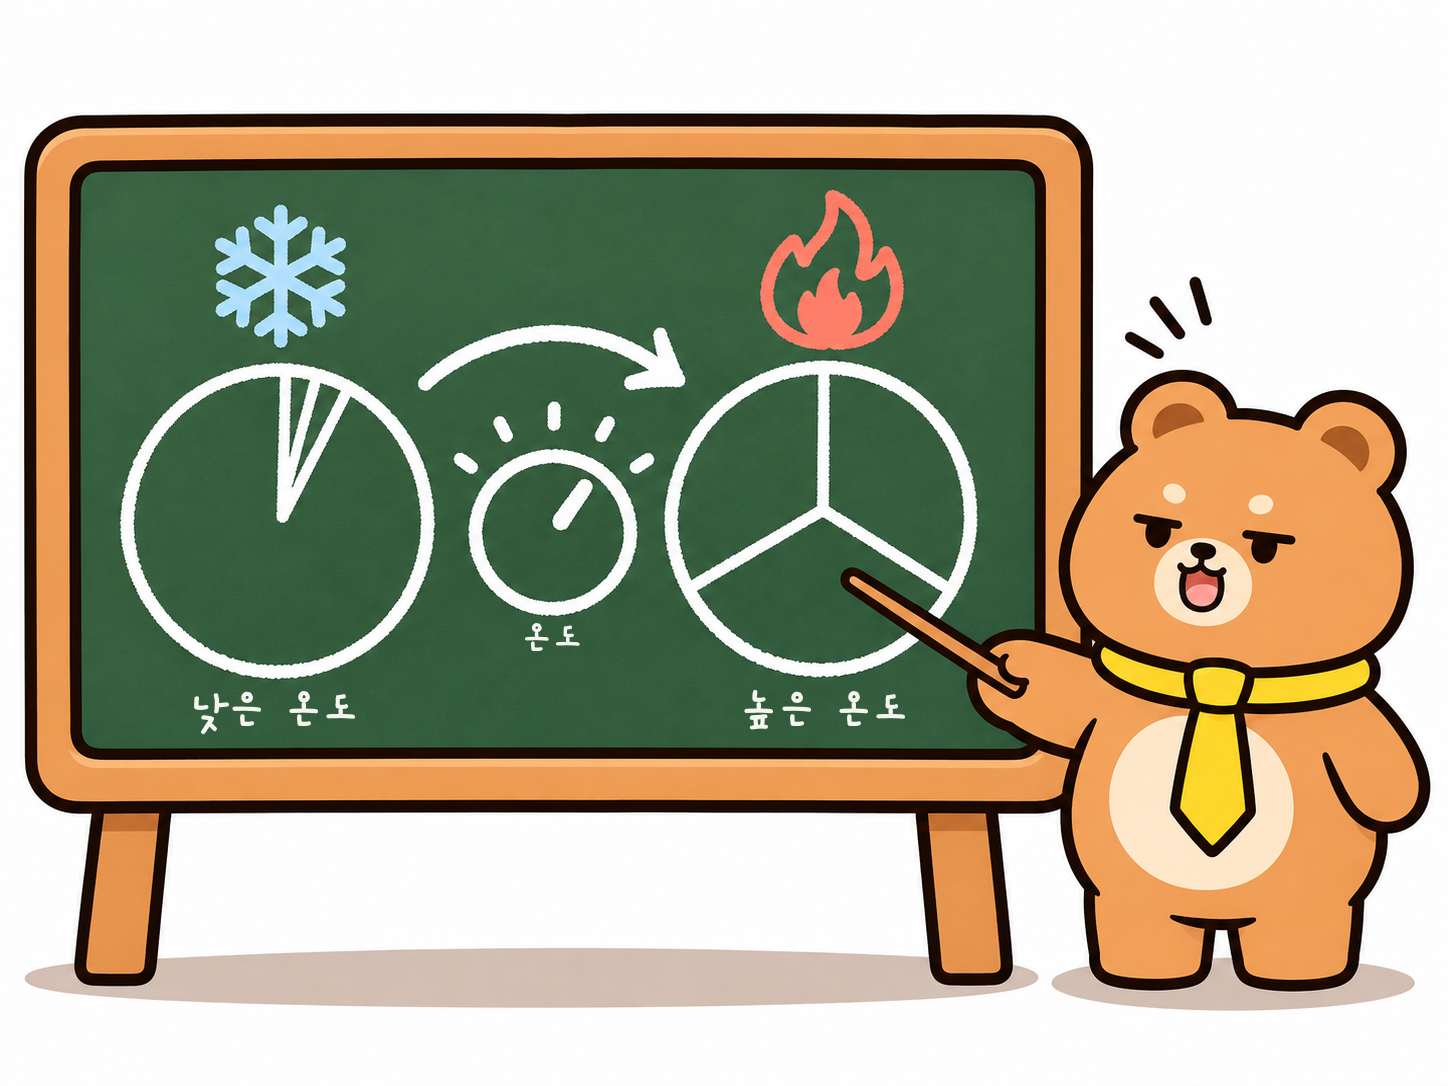
룰렛 칸 크기를 조절하는 설정도 있습니다. 온도(Temperature)입니다.
온도를 낮추면 넓은 칸이 더 넓어집니다. 1등이 거의 다 가져가요. 올리면 칸 크기가 서로 비슷해지고, 좁던 칸도 걸릴 기회가 생깁니다.
점심 예시에 온도를 걸어 보면 이렇게 됩니다.
| 짜장면 | 김치찌개 | 초밥 | |
| 0.3 (낮게) | 75.6% | 23.0% | 1.4% |
| 1 (기본) | 50.0% | 35.0% | 15.0% |
| 2 (높게) | 41.9% | 35.1% | 23.0% |
* 앞의 예시 확률에 아래 식을 그대로 넣어 계산한 값입니다.
온도 0.3이면 초밥은 1.4%, 거의 안 나옵니다. 온도 2면 23%까지 올라와서 네댓 번에 한 번은 걸립니다.
전공자용 한 줄
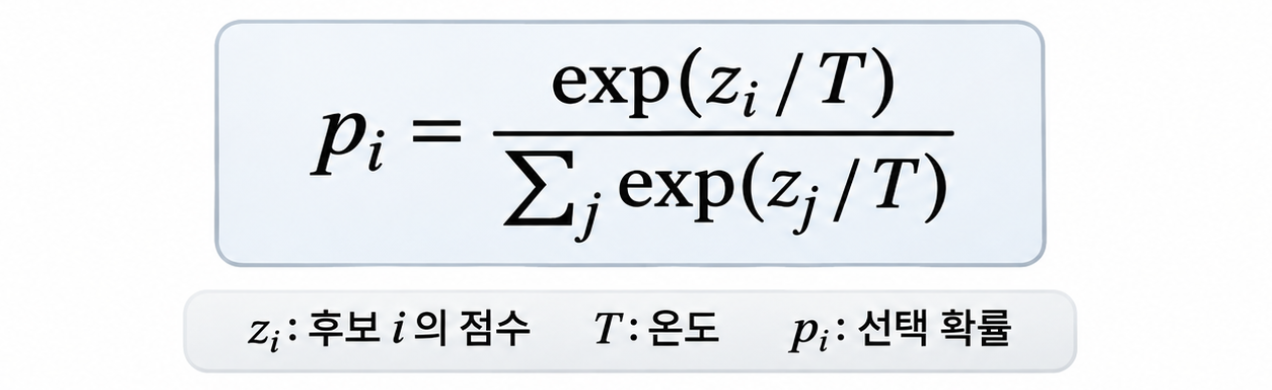
점수를 T로 나누는 게 전부입니다. 지식 증류 논문에서 '부드러운' 확률을 만들 때 쓴 식과 같은 꼴입니다[2].
그럼 온도를 끝까지 올리면요?
로봇: 점심은 우주 구름 비빔 양말입니다!
과장했지만 방향은 맞습니다. 평소엔 거의 안 나올 말이 자꾸 걸리면서 글이 엉뚱해지거든요. 앞의 워싱턴대 연구도 확률이 아주 낮은 후보들, 이른바 '꼬리'를 문제로 짚었습니다. 그래서 이 꼬리를 잘라 내고 남은 후보로만 룰렛을 돌리는 방법(Top-p)도 같이 씁니다[1].
2-3. 온도를 0으로 하면 늘 같은 답일까?
온도를 0에 가깝게 내리면 거의 1등만 고릅니다. 그러면 매번 같은 답이 나올 것 같은데, 꼭 그렇지는 않습니다. Anthropic API 문서에도 온도를 0.0으로 해도 완전히 결정적이지는 않다고 적혀 있습니다[3].
재밌는 실험이 하나 있습니다. Thinking Machines Lab이 Qwen3-235B 모델에 같은 질문을 온도 0으로 1,000번 보냈더니, 서로 다른 답이 80가지 나왔습니다[4].
이 실험에서 찾은 원인은 서버 쪽 계산이었습니다. 서버는 여러 사람의 요청을 묶어서 한꺼번에 처리하는데, 같이 묶인 요청 수에 따라 계산 결과의 소수점 끝자리가 조금씩 달라졌습니다. 1등과 2등 점수가 아슬아슬하면 그 작은 차이로 순위가 뒤집힐 수 있고요[4].
온도를 0으로 낮추면 결과가 더 일관되긴 하지만, 늘 같은 답을 보장하지는 않습니다.
2-4. 채팅 앱에서는 왜 못 돌릴까?
쪼덕: 나도 다이얼 돌려 볼래! 문곰: 잠깐. 일반 채팅 앱에선 보통 못 돌려.
ChatGPT나 Claude 앱 화면에는 온도 설정이 없습니다(글 쓸 당시 기준). 온도는 개발자가 API로 AI를 불러 쓸 때 넣는 값이에요.
그마저도 요즘은 기본값을 그대로 두라는 쪽입니다. 예를 들어 구글은 Gemini 3에서는 온도를 기본값 1.0으로 두라고 강하게 권합니다. 추론 능력이 기본 설정에 맞춰져 있다는 이유입니다[5].
결국 쓰는 사람이 바꿀 수 있는 건 손잡이가 아니라 질문입니다. 이건 조금 있다가 다룹니다.
3. 답이 뒤집히는 진짜 이유
3-1. 반반이라서 뒤집힌 게 아니다
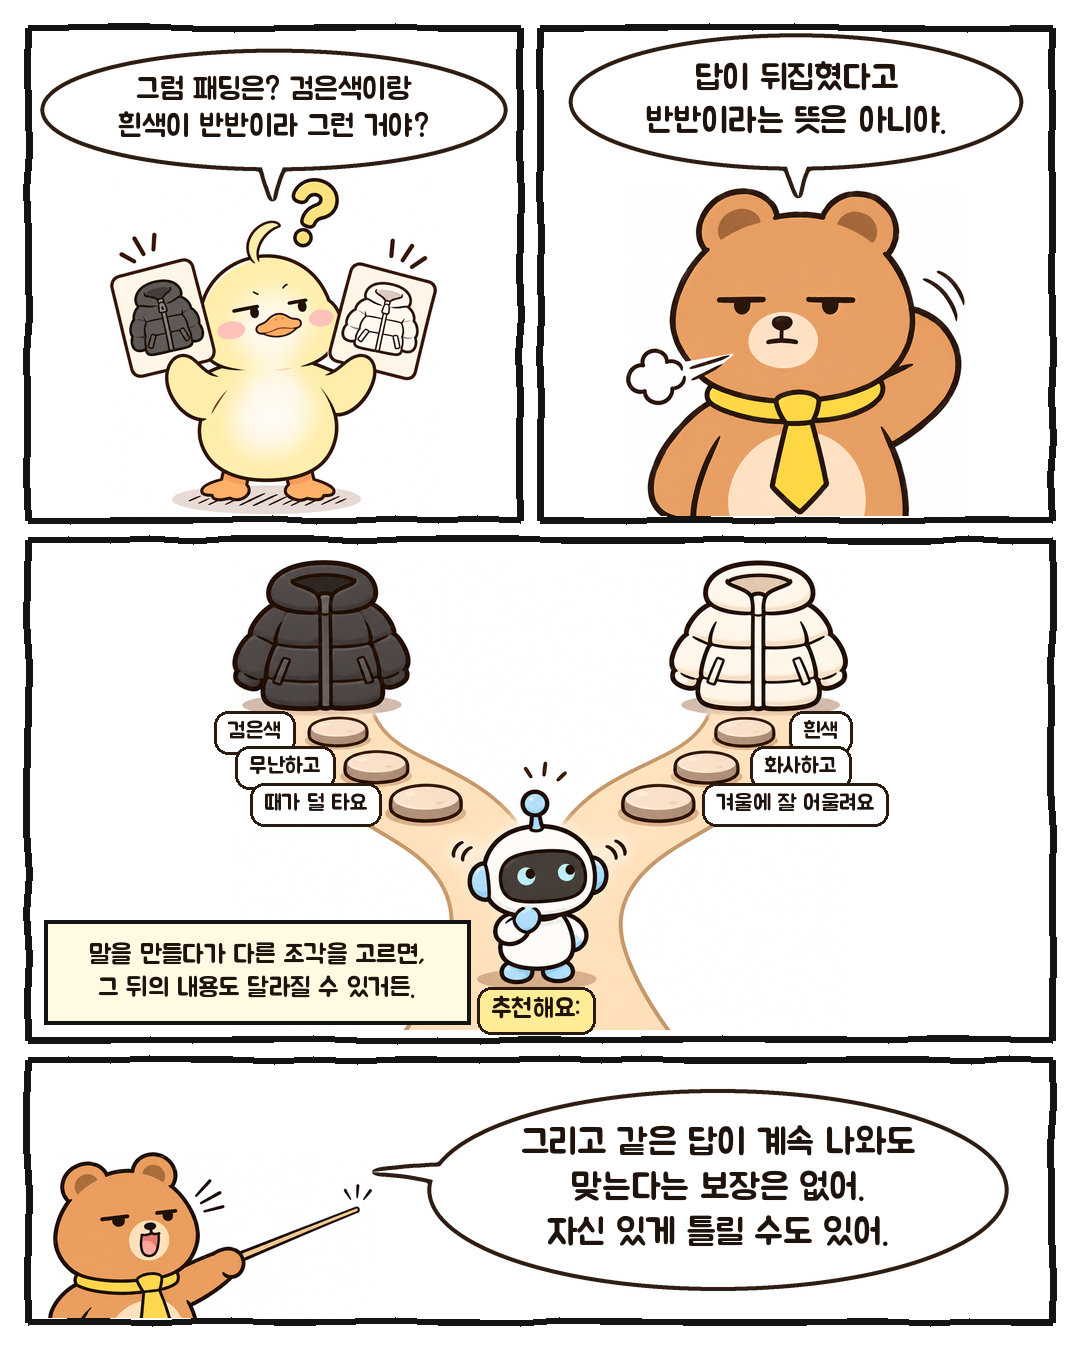
쪼덕: 그럼 패딩은? 검은색이랑 흰색이 반반이라 그런 거야? 문곰: 답이 뒤집혔다고 반반이라는 뜻은 아니야.
AI는 조각을 하나씩 고른다고 했죠. 그래서 먼저 고른 조각이 뒤를 끌고 갑니다.
"추천해요:" 다음에 '검은색'이 걸리면, 뒤에는 검은색에 맞는 이유가 붙습니다. "무난하고", "때가 덜 타요". '흰색'이 걸리면 "화사하고", "겨울에 잘 어울려요"가 붙고요.
처음엔 작은 갈림길이었는데, 도착지는 완전히 달라집니다.
그러니 답이 뒤집혔다고 확률이 반반이었다고 볼 순 없습니다. 70 대 30이어도 30 쪽이 걸리면 뒤집힙니다. 일단 걸리고 나면 그쪽으로 이유가 그럴듯하게 따라붙고요.
AI가 "흰색을 추천해요!"라고 단호하게 말했다고 흰색에 자신이 있었던 것도 아닙니다. 말투의 확신과 실제 확률은 별개입니다.
3-2. 같은 답이 계속 나와도 정답은 아니다
반대 경우도 있습니다.
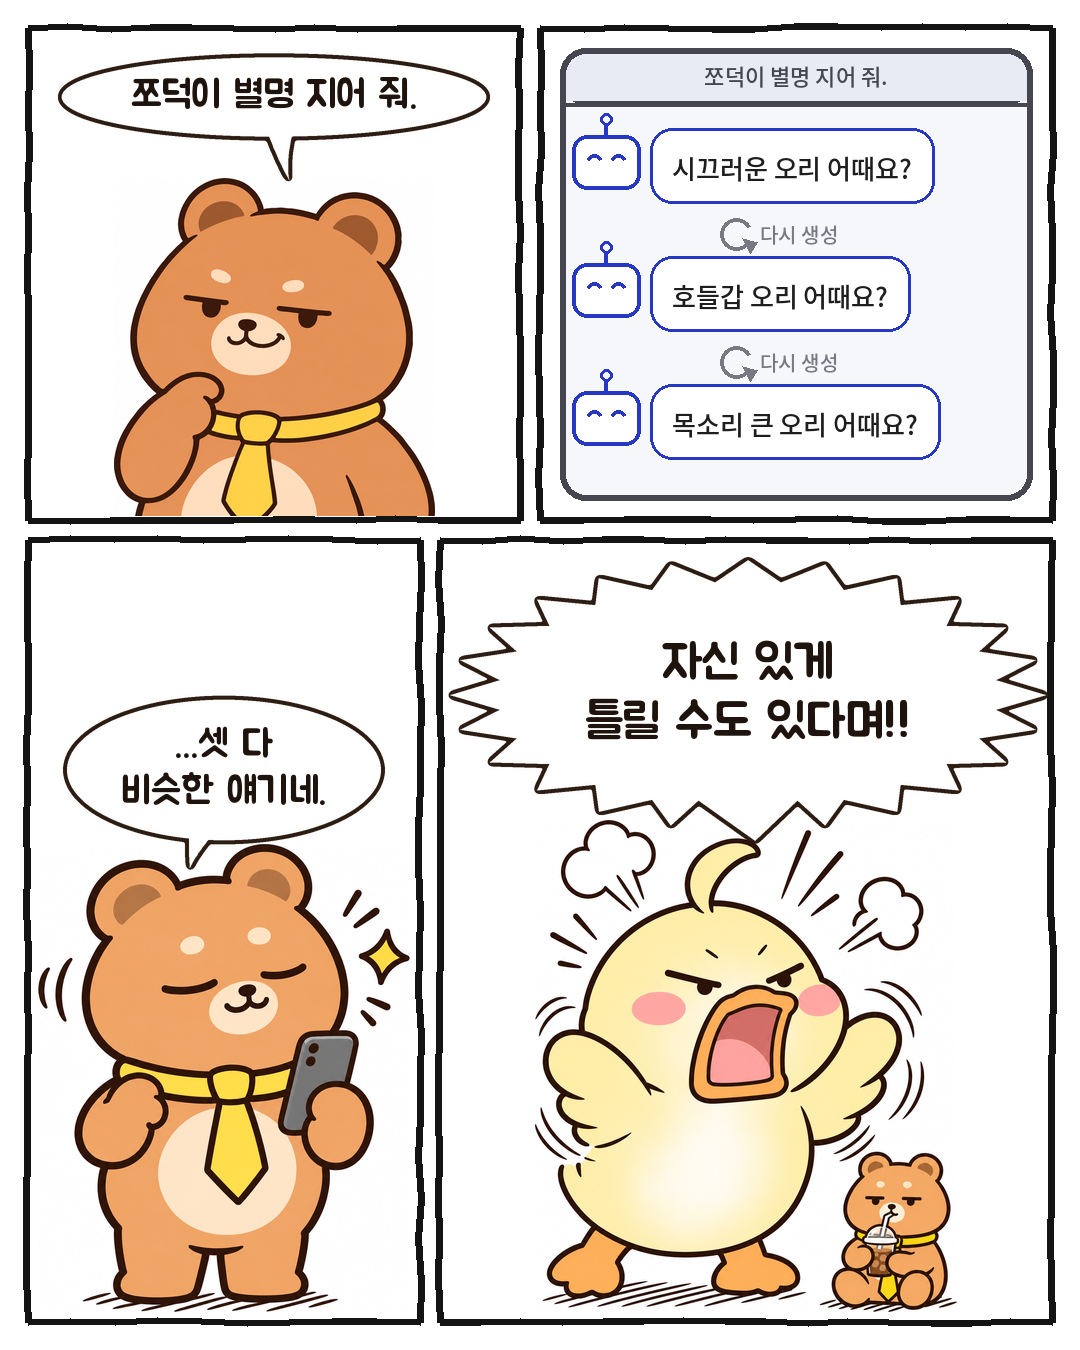
문곰이 쪼덕이 별명을 지어 달라고 하자 "시끄러운 오리", "호들갑 오리", "목소리 큰 오리"가 나왔습니다.
문곰: ...셋 다 비슷한 얘기네. 쪼덕: 자신 있게 틀릴 수도 있다며!!
세 번 다 시끄럽다는 별명이 나오자 쪼덕이가 따집니다. 그것도 목청껏요. 정작 본인이 별명을 증명하고 있네요.
별명에는 정답이 없으니 웃고 넘길 수 있습니다. 하지만 사실을 묻는 질문이라면 얘기가 달라집니다. 같은 답이 여러 번 나와도 그게 정답이라는 보장은 없거든요. AI는 자연스러운 문장을 만드는 데는 능숙하지만, 자연스러운 문장이 꼭 사실인 건 아닙니다. 같은 오답을 반복한다고 그 답이 사실이 되지는 않습니다. 이 얘기는 할루시네이션 글에 더 자세히 써 두었습니다.
AI가 '그럴듯하게 틀리는' 진짜 이유 (할루시네이션)
AI가 '그럴듯하게 틀리는' 진짜 이유 (할루시네이션)
2023년, 미국 뉴욕의 한 변호사가 법원에 제출한 서면 때문에 미국 법조계가 술렁였습니다.자기 주장을 뒷받침하려고 판례 6건을 인용했는데, 그중 단 한 건도 실제로 존재하지 않았기 때문입니
www.gominq.com
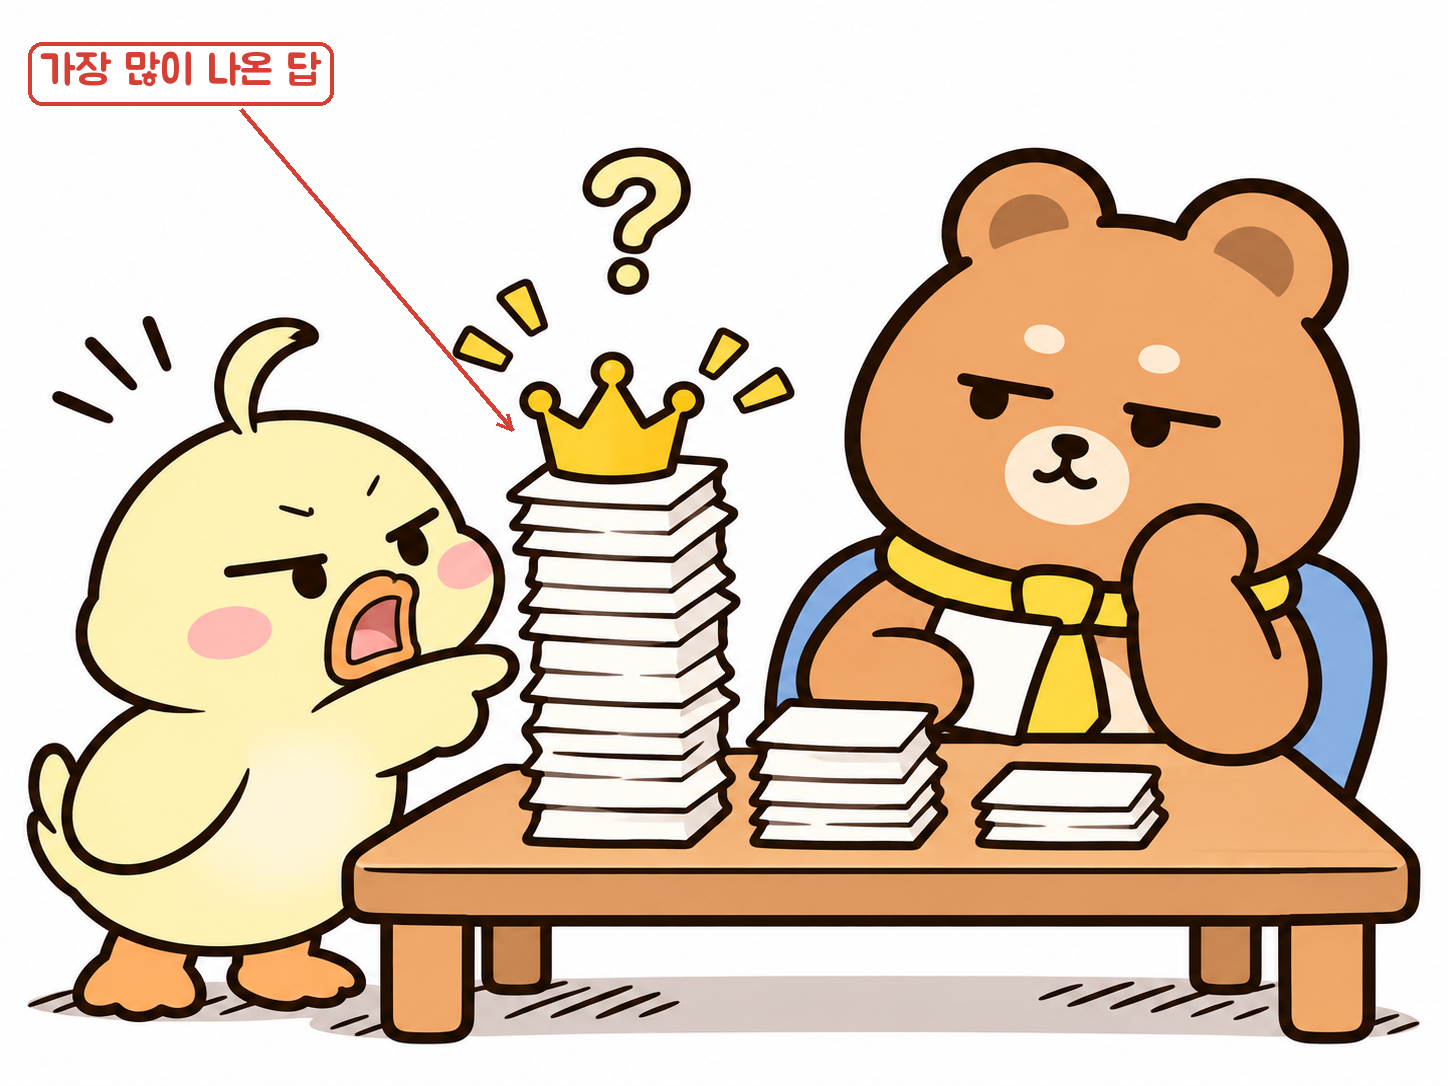
여러 번 뽑는 걸 일부러 활용하는 연구도 있긴 합니다. 구글 연구팀은 AI에게 수학 문제의 풀이 과정을 여러 갈래로 만들게 한 뒤, 가장 많이 나온 답을 고르게 했습니다. 자기 일관성(Self-Consistency)이라는 방법입니다. PaLM-540B 모델의 초등 수학(GSM8K) 정답률이 56.5%에서 74.4%로 올랐습니다[6].
정답률이 올랐을 뿐, 다수결 답이 늘 맞는 건 아닙니다. 그리고 이건 풀이 과정을 여러 개 만들어 집계하는 연구 방법이라, 채팅 앱에서 다시 생성을 두세 번 누르는 것과는 다릅니다.
4. 답이 오락가락할 때 이렇게 해 보세요
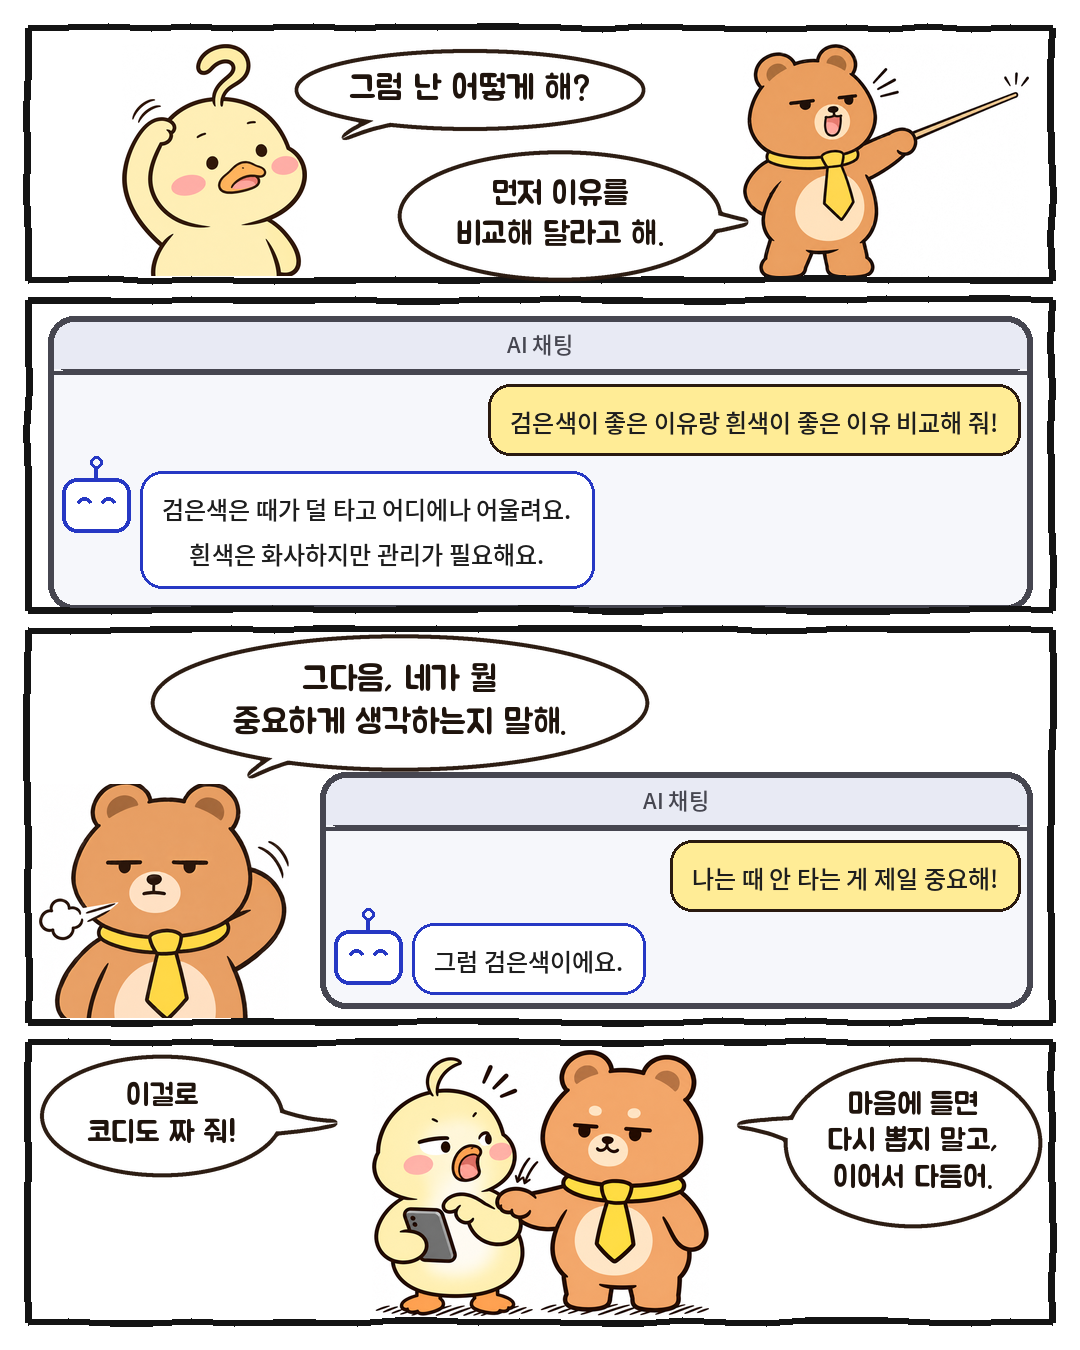
쪼덕: 그럼 난 어떻게 해?
손잡이는 못 돌려도 질문은 바꿀 수 있습니다.
① 결론 말고 이유를 비교해 달라고 하기
"뭐 살까?" 대신 "각각 좋은 이유를 비교해 줘"라고 물어보세요. 결론은 뽑을 때마다 뒤집혀도, 비교 내용은 크게 안 바뀝니다. 고르는 건 내가 하면 되고요.
② 내 기준을 먼저 말하기
쪼덕: 나는 때 안 타는 게 제일 중요해!
기준을 알려 주면 AI가 갈 수 있는 길이 확 좁아집니다. 룰렛 칸이 한쪽으로 쏠리는 셈이라, 다시 뽑아도 답이 잘 안 뒤집힙니다.
③ 마음에 드는 답이 나오면 이어서 다듬기
다시 생성은 룰렛을 처음부터 다시 돌립니다. 괜찮은 답이 나왔으면 버튼 대신 "이걸로 코디도 짜 줘"처럼 그 답에 이어서 말하세요.
문곰: 마음에 들면 다시 뽑지 말고, 이어서 다듬어.
④ 정답이 있는 질문은 따로 확인하기
계산이나 사실 확인처럼 정답이 있는 질문은 답이 여러 번 같아도 안심하면 안 됩니다. 반대로 뽑을 때마다 답이 다르면, 그 질문에서는 AI 답이 일관되지 않다는 뜻이고요. 중요한 내용은 계산기나 믿을 만한 자료로 한 번 더 확인하는 게 좋습니다.
5. 정리: AI의 답은 칸 크기가 다른 뽑기다
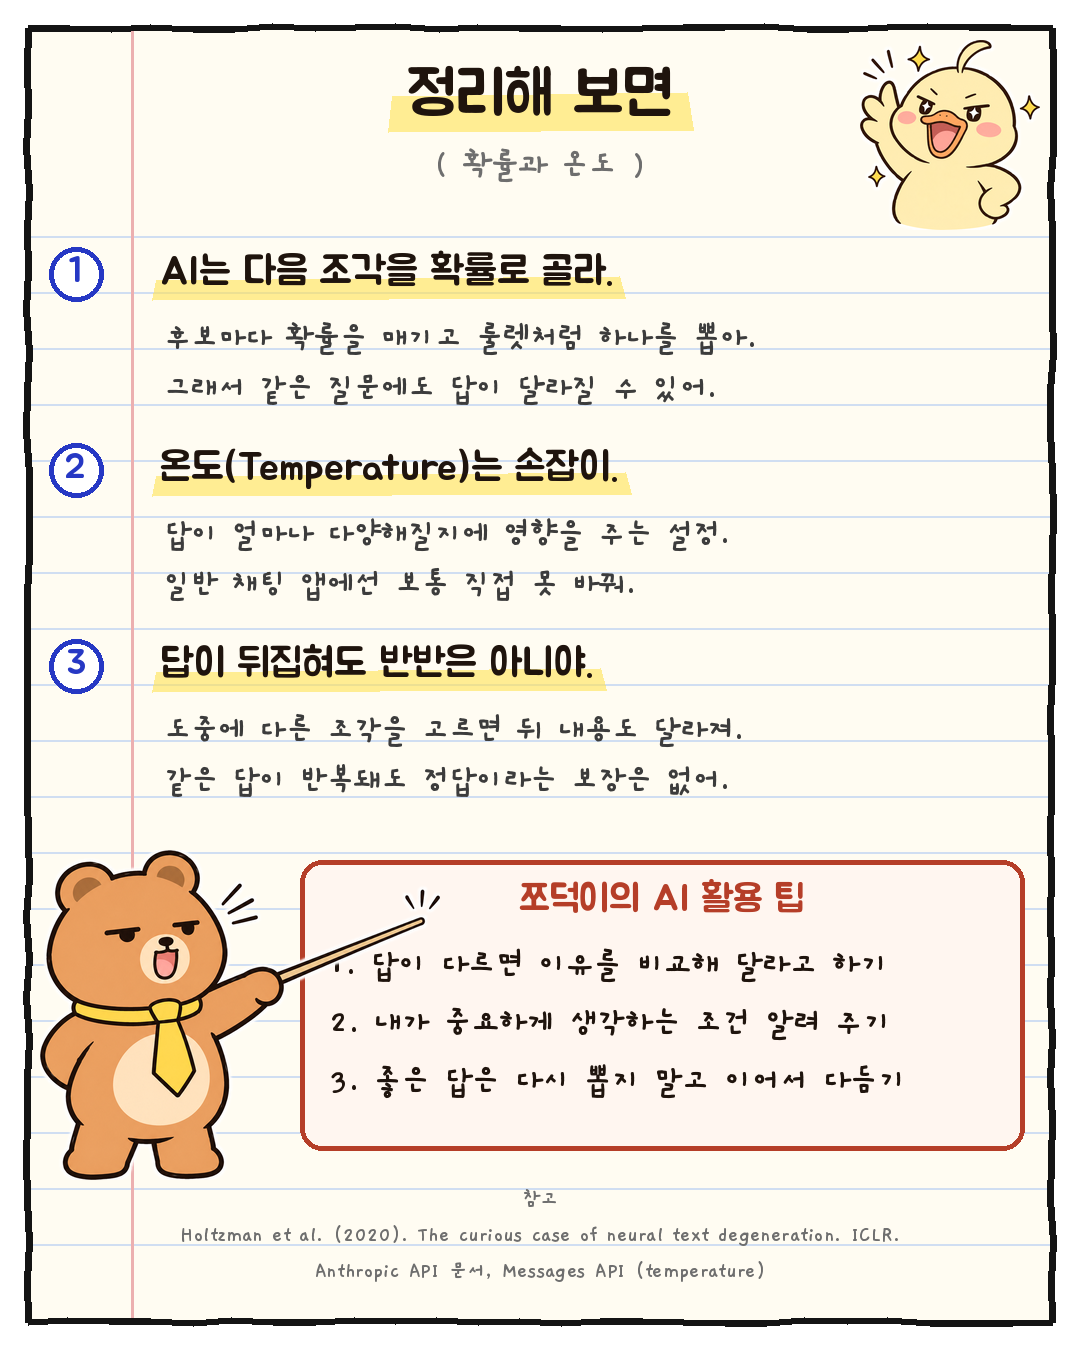
AI가 같은 질문에 매번 다르게 답하는 이유를 알아봤습니다.
AI는 다음에 올 조각을 확률에 따라 하나씩 뽑으며 답을 만듭니다. 다시 생성은 그 뽑기를 처음부터 다시 하는 거라, 답이 바뀌는 게 자연스럽습니다.
온도는 그 룰렛의 칸 크기를 조절하는 손잡이입니다. 낮추면 뻔해지고 높이면 엉뚱해집니다. 0으로 내려도 늘 같은 답이 나오지는 않고요.
답이 뒤집혔다고 반반이었던 것도 아니고, 같은 답이 반복된다고 정답인 것도 아닙니다. 답이 오락가락하면 버튼을 연타하기보다 이유를 비교해 달라고 하고, 내 기준을 먼저 말해 보세요.
문곰과 쪼덕이의 다른 이야기는 인스타그램에서 볼 수 있습니다.
지난 화: AI는 왜 내 이름을 까먹을까? (컨텍스트 윈도우)
참고 자료
[1] Holtzman, A. et al. (2020), The Curious Case of Neural Text Degeneration, ICLR 2020 https://arxiv.org/abs/1904.09751
[2] Hinton, G., Vinyals, O., Dean, J. (2015), Distilling the Knowledge in a Neural Network https://arxiv.org/abs/1503.02531
[3] Anthropic, Messages API Reference (temperature) https://docs.anthropic.com/en/api/messages
[4] Thinking Machines Lab (2025), Defeating Nondeterminism in LLM Inference https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/
[5] Google Cloud, Gemini 3 prompting guide https://docs.cloud.google.com/vertex-ai/generative-ai/docs/start/gemini-3-prompting-guide
[6] Wang, X. et al. (2023), Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023 https://arxiv.org/abs/2203.11171