[만화][AI] AI는 왜 내 이름을 까먹을까? (컨텍스트 윈도우)
- AI, Why? | 만화로 보는 AI
- 2026. 11. 16.
ChatGPT나 Claude와 한참 대화하다 보면 가끔 황당한 일이 생깁니다.
분명 처음에 알려 준 내용을 다시 물어보거나, 몇 번이나 강조했던 조건을 슬쩍 빼먹기도 하죠.
"아까 말했잖아!"
AI를 쓰면서 이런 말을 해 본 적이 있다면 오늘 이야기가 낯설지 않을 겁니다.
쪼덕이도 비슷한 일을 겪었거든요.
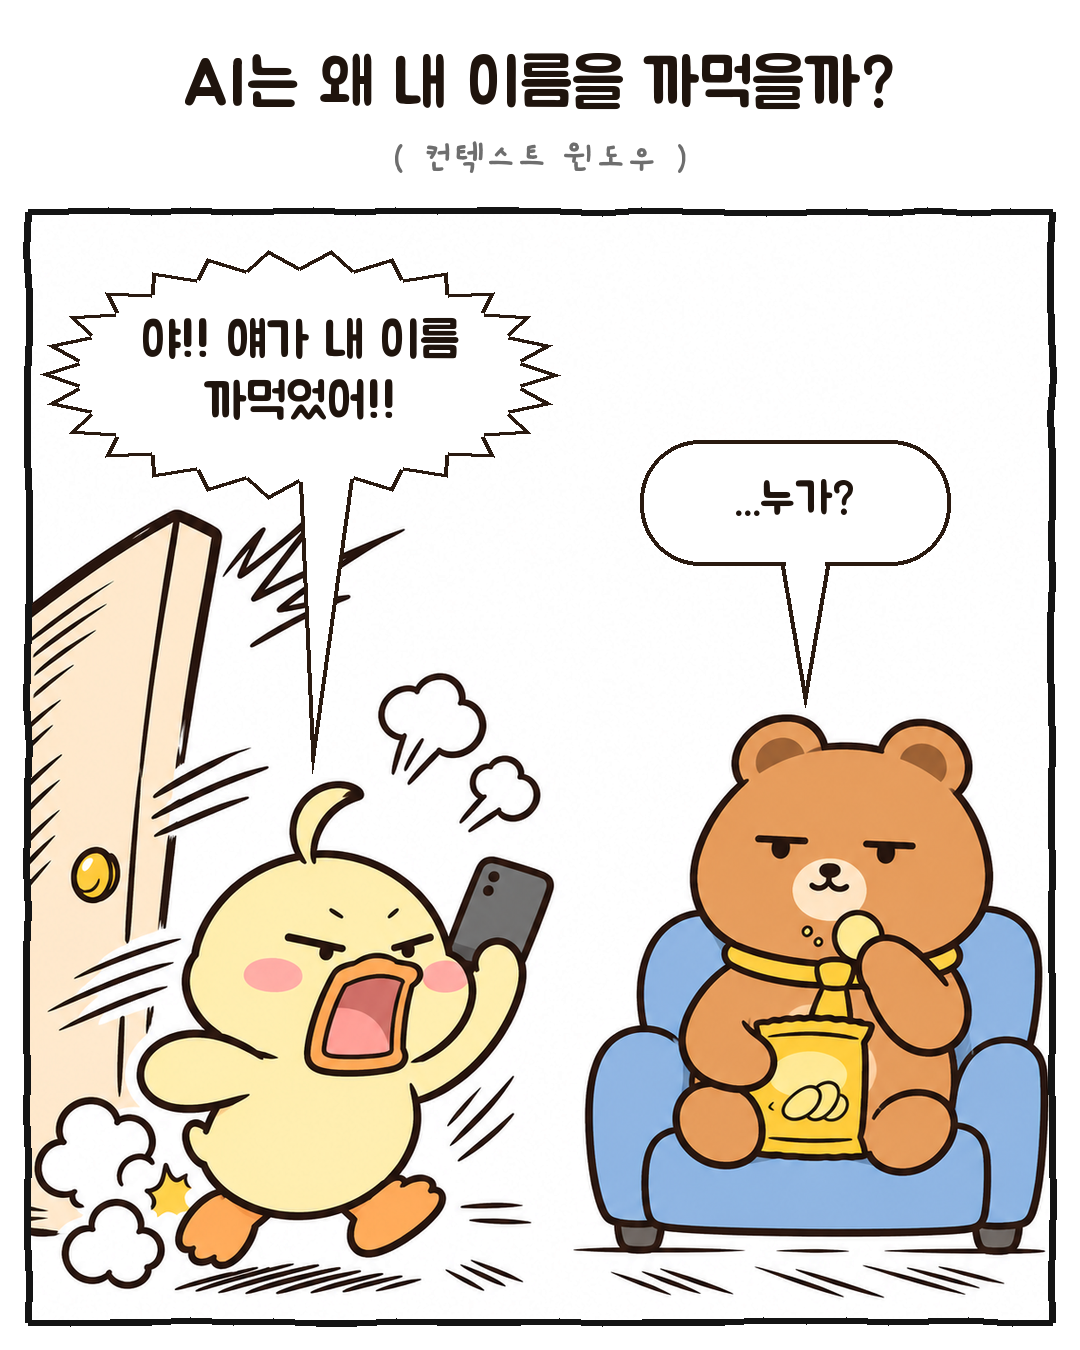
쪼덕: 야!! 얘가 내 이름 까먹었어!!
문곰: ...누가?
쪼덕이는 AI와 두 시간 동안 수다를 떨었습니다.
대화 맨 처음에는 "우리 오늘부터 절친이다! 내 이름은 쪼덕이야, 잊지 마!"라고 신신당부까지 했죠.
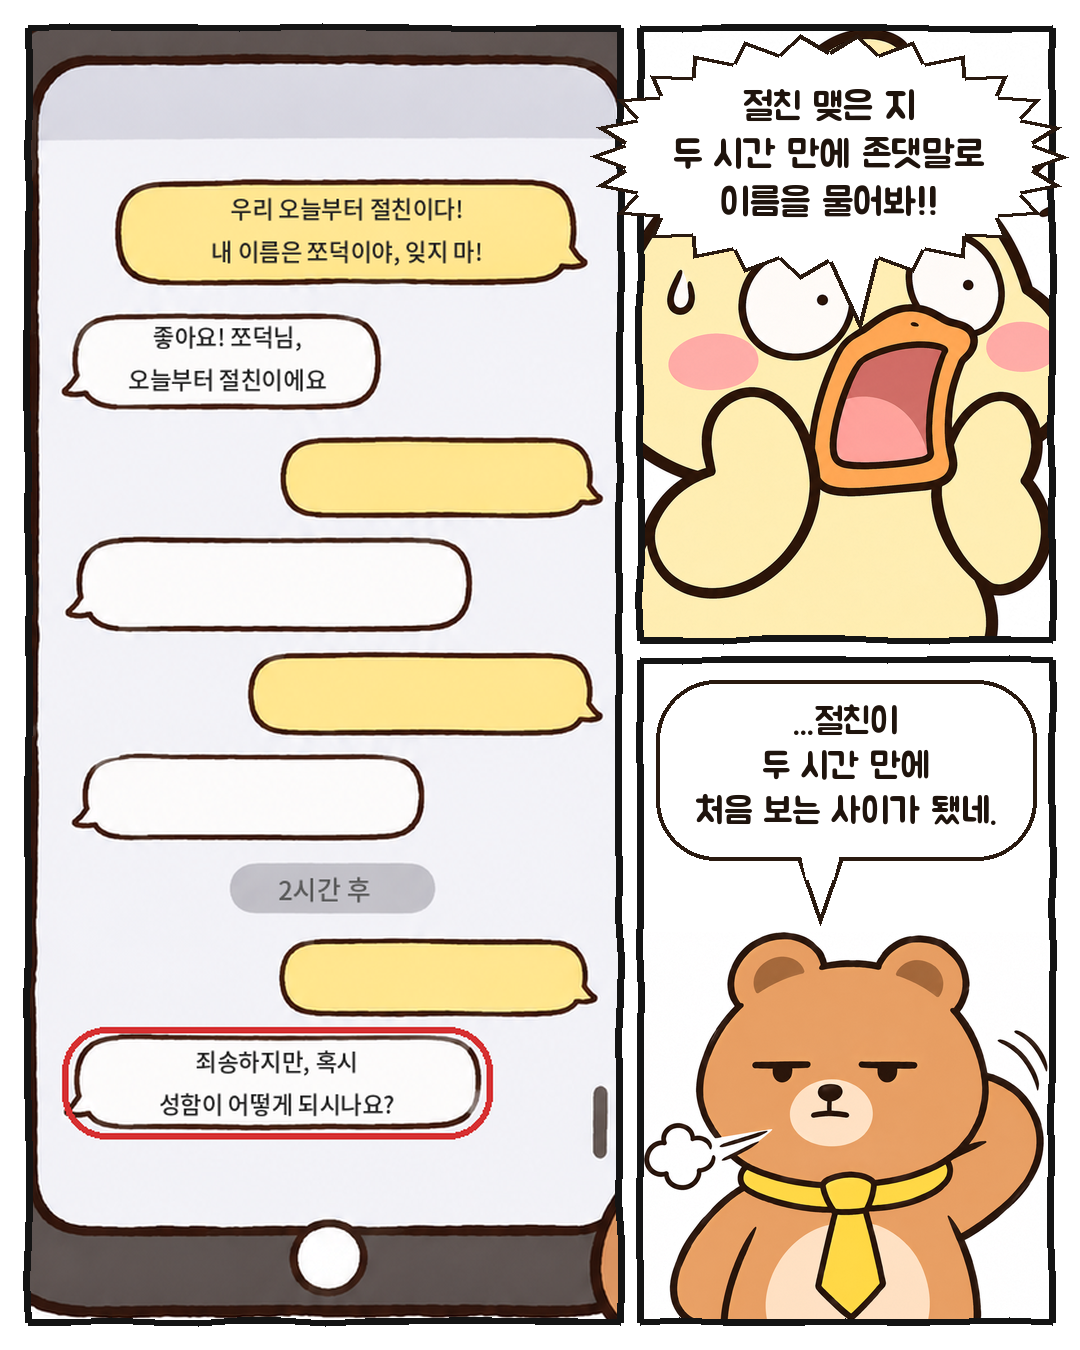
그런데 두 시간 뒤, AI가 이렇게 물었습니다.
"죄송하지만, 혹시 성함이 어떻게 되시나요?"
절친이 두 시간 만에 처음 보는 사이가 된 겁니다.
그럼 AI는 정말 쪼덕이의 이름을 까먹은 걸까요?
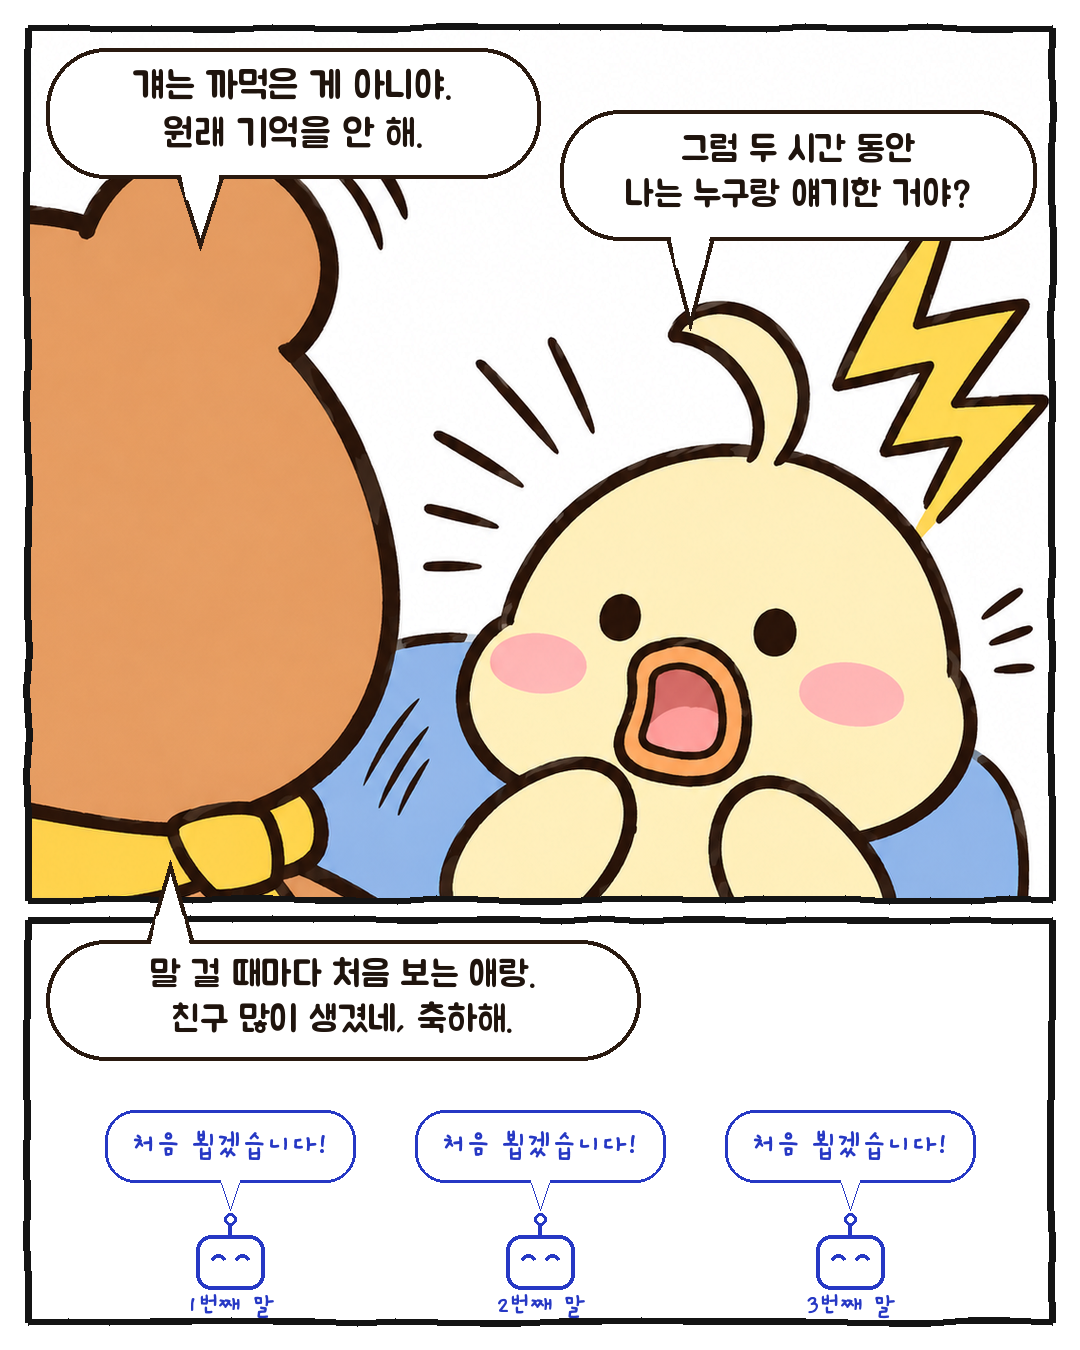
문곰: 걔는 까먹은 게 아니야. 원래 기억을 안 해.
무슨 소리일까요?
AI는 대화를 이어 가는 방식부터 사람과 다릅니다. 그리고 이 차이를 이해하려면 컨텍스트 윈도우(Context Window)라는 개념을 알아야 합니다.
이름이 어디로 사라졌는지부터 알아보겠습니다.
1. AI는 어떻게 대화를 기억할까?
1-1. AI는 원래 대화를 기억하지 않는다
친구와 대화할 때는 앞에서 들은 이야기를 기억하면서 말을 이어 갑니다.
AI도 겉보기에는 비슷합니다. 조금 전에 이야기한 내용을 물어보면 잘 대답하고, 앞에서 정한 조건에 맞춰 답을 바꾸기도 하죠.
그런데 AI 모델 자체가 대화를 기억하는 방식은 사람과 다릅니다.
기본적으로 언어 모델에 보내는 요청은 각각 독립적입니다. 모델이 이전 대화 내용을 스스로 계속 간직하는 것이 아니라, 필요한 대화 기록을 입력으로 전달받아 답변을 만드는 방식이죠.
이런 성질을 개발 용어로 스테이트리스(Stateless, 무상태)라고 합니다.
OpenAI 개발자 문서에서도 기본적인 텍스트 생성 요청은 독립적이며 상태가 없다고 설명합니다.[1]
그런데 이상하죠.
우리가 사용하는 채팅 앱에서는 분명 앞에서 한 말을 기억하는 것처럼 행동하니까요.
비밀은 생각보다 간단합니다.
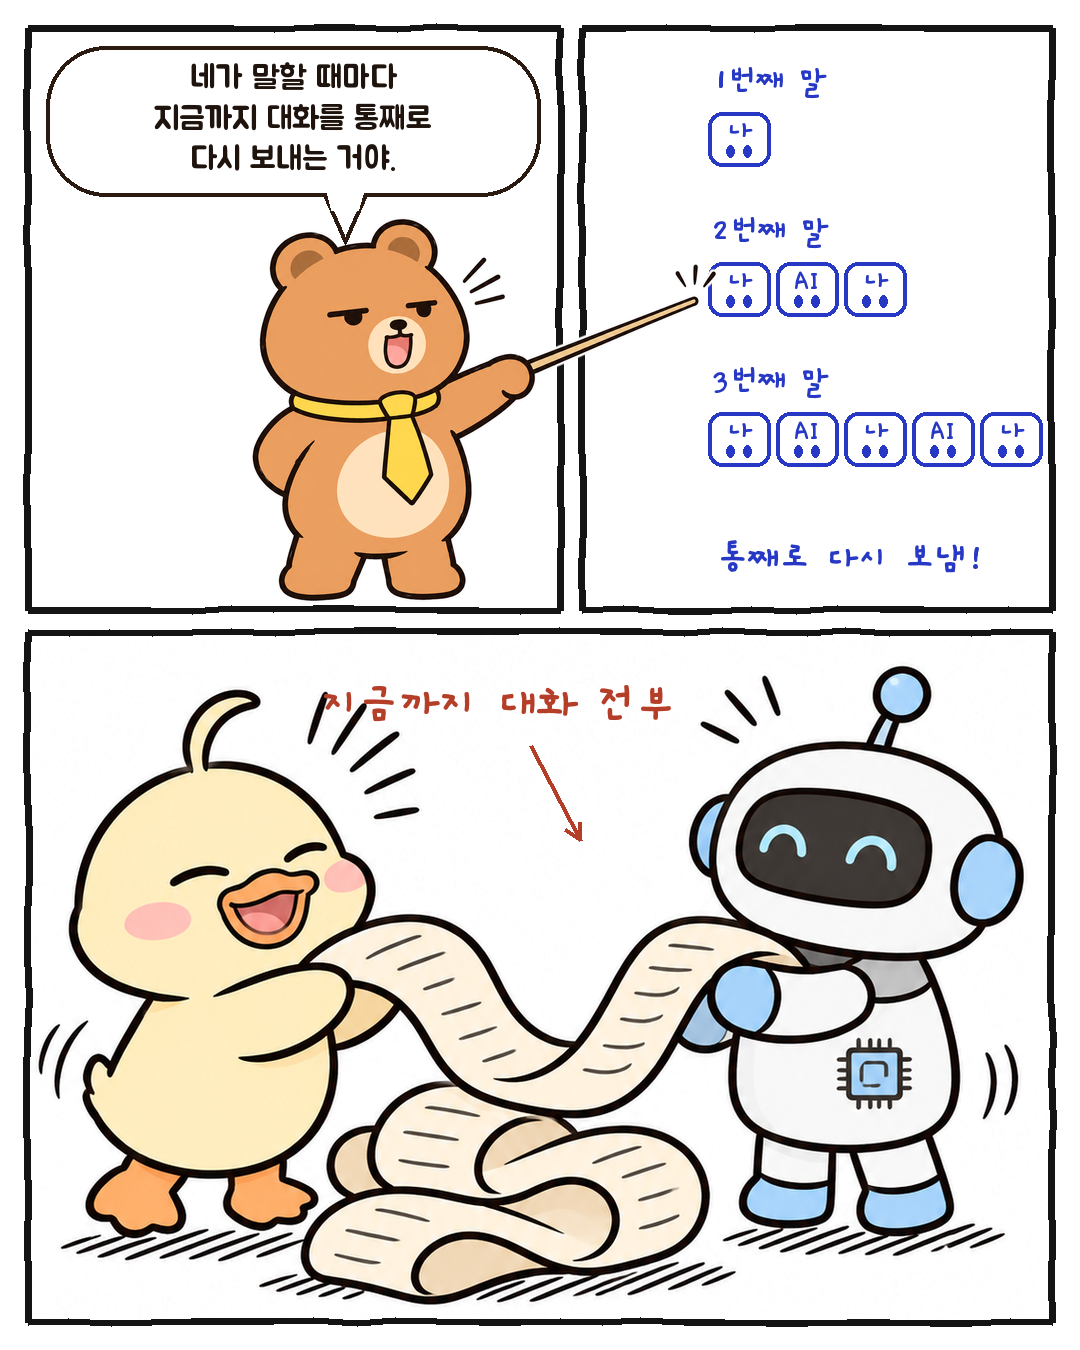
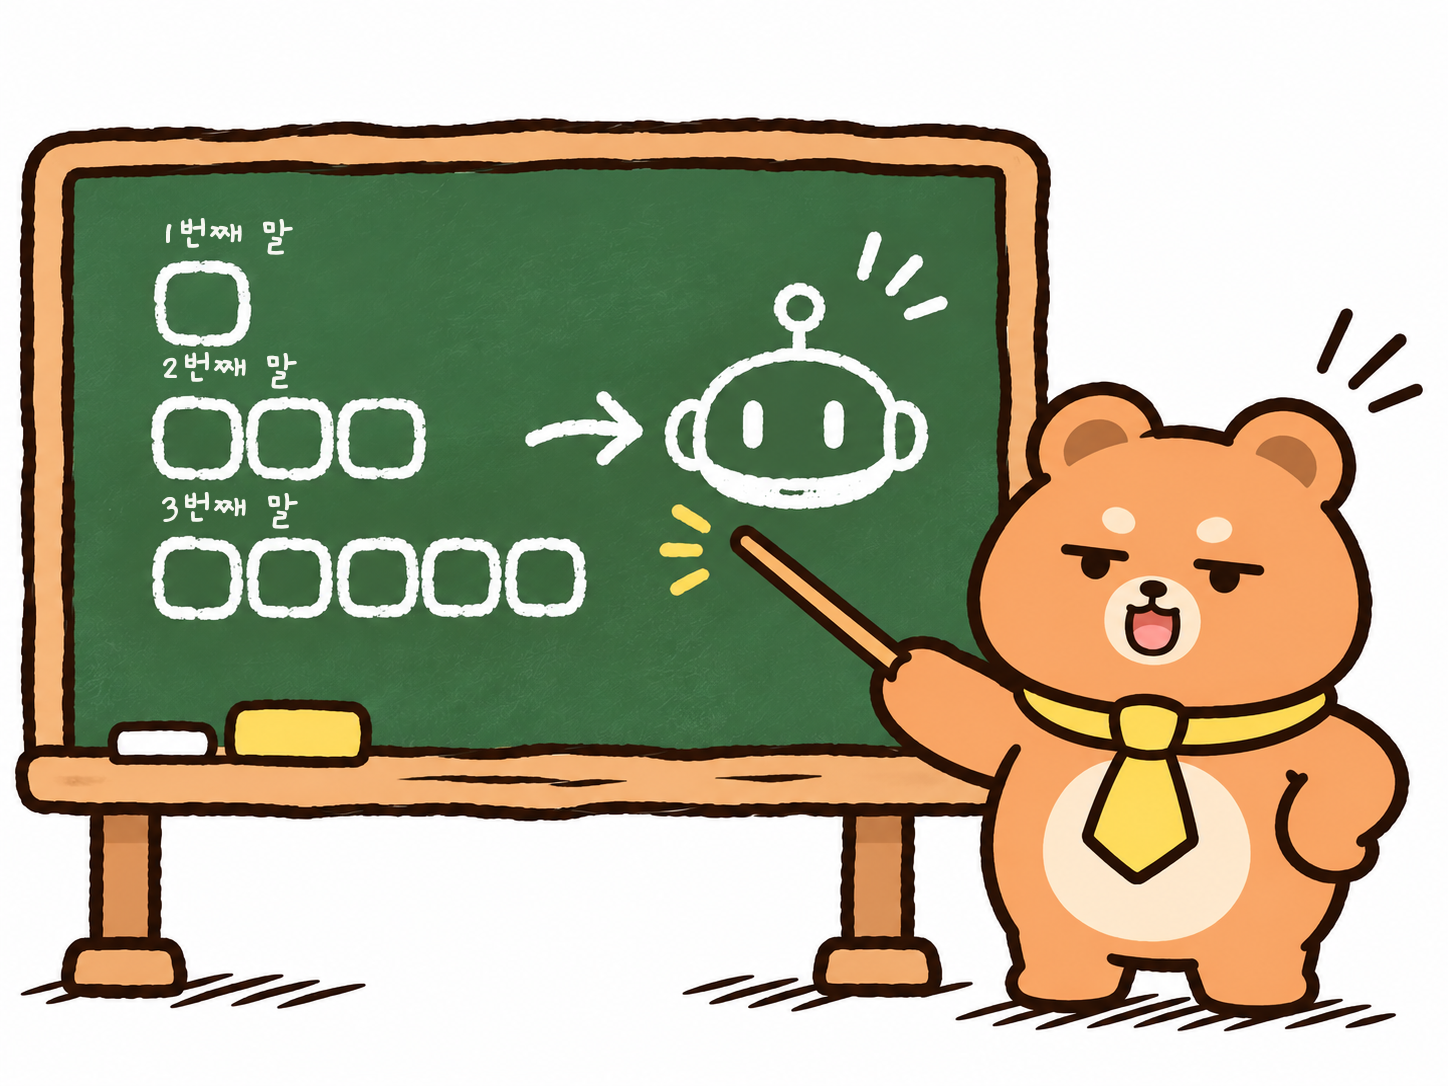
가장 기본적인 방법은 이전 대화 기록을 새로운 질문과 함께 AI에게 전달하는 겁니다.
예를 들어 처음 질문할 때는 내가 보낸 메시지 하나가 전달됩니다.
두 번째 질문을 할 때는 첫 번째 질문, AI가 했던 답변, 그리고 새 질문이 함께 들어갑니다.
세 번째에는 앞에서 주고받은 내용이 또 포함되죠.
대화가 길어질수록 AI에게 전달해야 하는 내용도 늘어나는 겁니다.
물론 실제 채팅 서비스가 항상 모든 대화를 처음부터 끝까지 보내는 것은 아닙니다. 오래된 내용을 요약하거나 필요한 기록만 골라 전달하기도 합니다.
하지만 기본 원리는 같습니다. AI가 이전 대화를 이어 갈 수 있는 건, 그 내용을 다시 참고할 수 있도록 전달받기 때문입니다.
고객센터에 전화하는 상황을 떠올려 보면 이해하기 쉽습니다.
전화를 걸 때마다 새로운 상담원이 받는다고 해 봅시다.
새 상담원은 나를 처음 보지만, 이전 상담 기록을 읽으면 지난번 이야기를 자연스럽게 이어 갈 수 있습니다.
AI도 이와 비슷합니다.
쪼덕: 그럼 두 시간 동안 나는 누구랑 얘기한 거야?
문곰: 말 걸 때마다 처음 보는 애랑. 친구 많이 생겼네, 축하해.
그런데 여기서 문제가 하나 생깁니다.
상담 기록이 아무리 많아도 새 상담원이 한 번에 읽을 수 있는 양에는 한계가 있다는 거죠.
1-2. 컨텍스트 윈도우는 AI의 책상이다
AI 앞에 커다란 책상이 있다고 생각해 봅시다.
우리가 나눈 대화는 길게 이어진 두루마리입니다. AI는 그 두루마리를 책상 위에 펼쳐 놓고, 내용을 참고하면서 대답합니다.
그런데 책상은 무한정 넓지 않습니다.
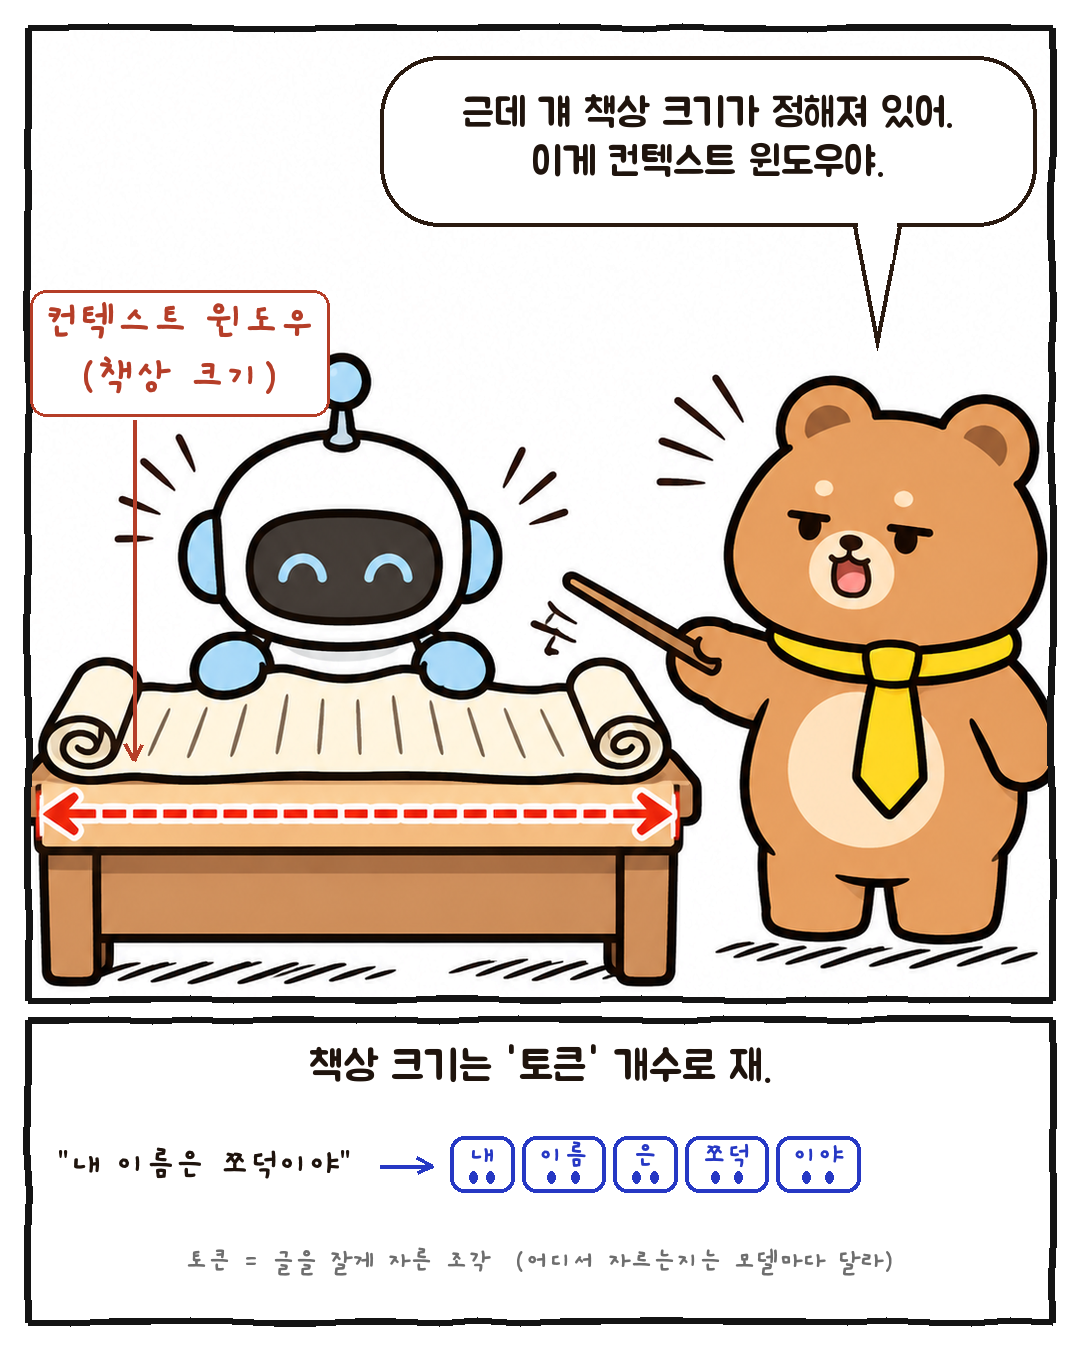
문곰: 근데 걔 책상 크기가 정해져 있어. 이게 컨텍스트 윈도우야.
이 책상의 크기가 바로 컨텍스트 윈도우(Context Window, 맥락 창)입니다.
쉽게 말하면 AI가 한 번의 요청에서 참고할 수 있는 정보의 범위입니다.[2]
책상 위에는 우리가 나눈 대화만 올라가는 게 아닙니다.
첨부한 문서나 이미지, 서비스가 미리 넣어 둔 지침, AI가 답변을 작성하는 데 필요한 공간까지 모두 포함됩니다.
긴 PDF 파일을 여러 개 올리면 생각보다 많은 자리를 차지할 수 있는 것도 이 때문입니다.
그런데 조금 이상하지 않나요?
AI는 엄청난 양의 글을 학습했다고 하는데, 고작 이름 하나를 기억하지 못한다니요.
그 이유는 AI가 학습한 지식과 지금 참고하는 정보가 서로 다르기 때문입니다.
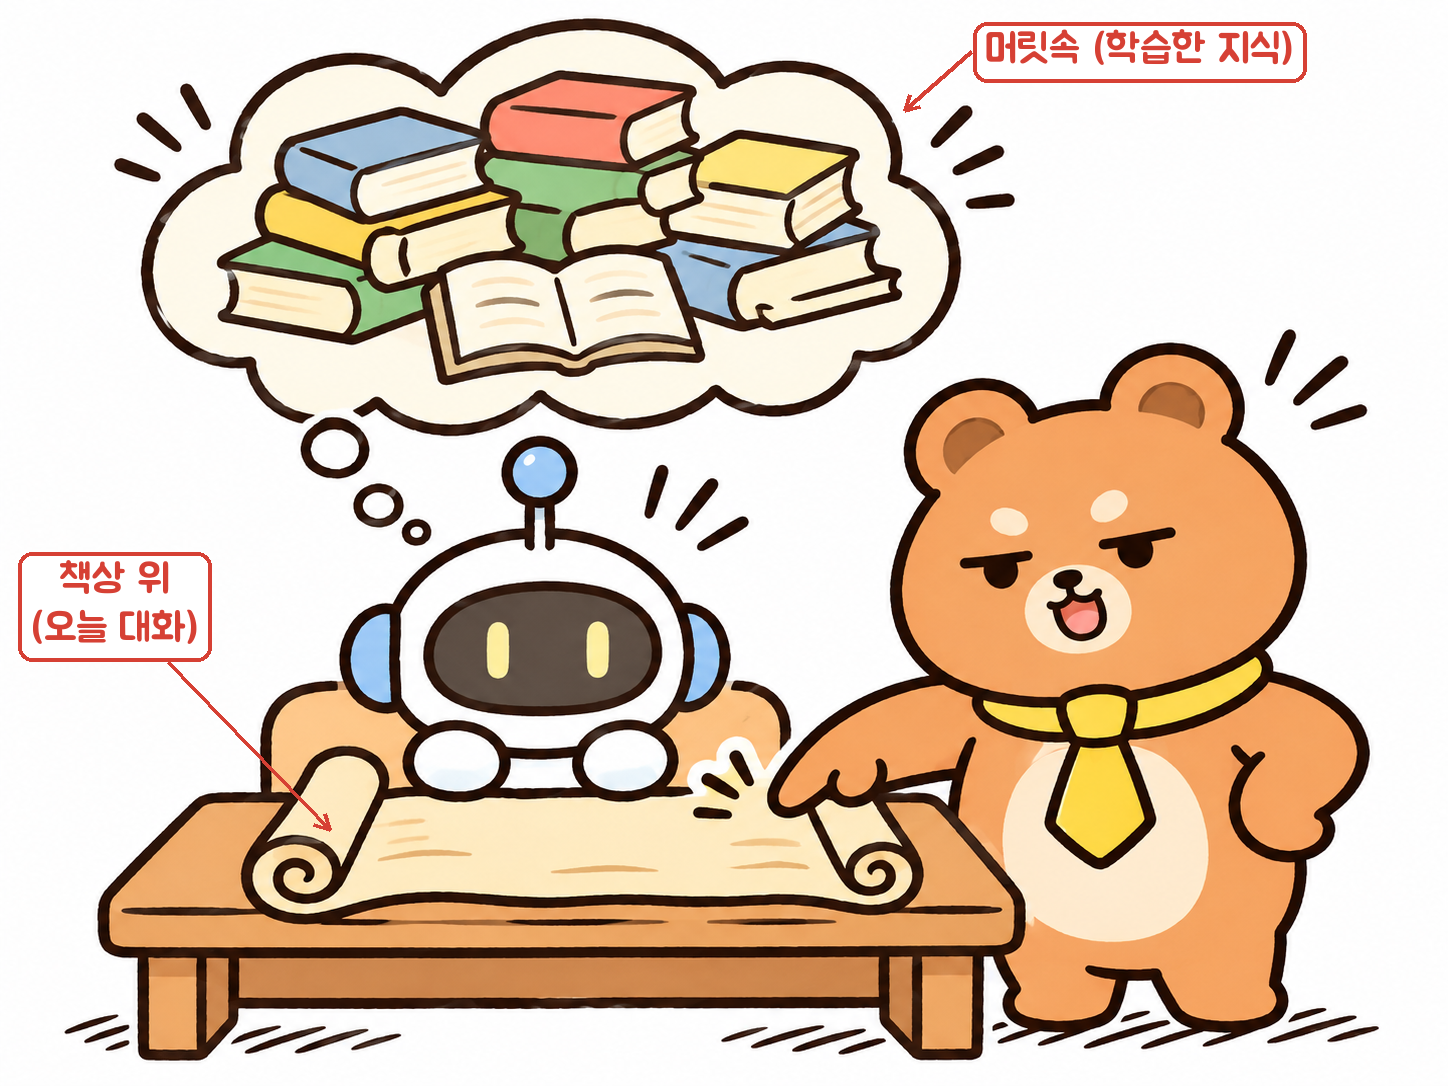
시험에 비유해 보겠습니다.
AI가 학습한 지식은 시험 전에 공부해서 머릿속에 익혀 둔 내용입니다.
반면 컨텍스트 윈도우는 오픈북 시험을 볼 때 책상 위에 펼쳐 놓은 자료에 가깝습니다.
AI는 학습한 지식을 활용할 수 있지만, 쪼덕이가 오늘 자기 이름을 알려 줬다는 사실은 별도로 전달받아야 합니다.
'쪼덕'이라는 이름은 지금 대화에서 알려 준 정보니까요.
책상 위 자료에서 그 이름이 빠졌고 다른 곳에서도 가져올 수 없다면, AI는 이름을 알 방법이 없습니다.
1-3. 책상 크기를 재는 단위, 토큰(Token)
그렇다면 AI의 책상은 얼마나 클까요?
컨텍스트 윈도우의 크기는 보통 글자 수가 아니라 토큰(Token)이라는 단위로 나타냅니다.
토큰은 AI가 글을 처리할 때 사용하는 작은 단위입니다.
사람은 문장을 읽을 때 단어와 문장의 의미를 자연스럽게 파악하지만, AI는 입력된 글을 토큰이라는 조각으로 나눠 처리합니다.[3]
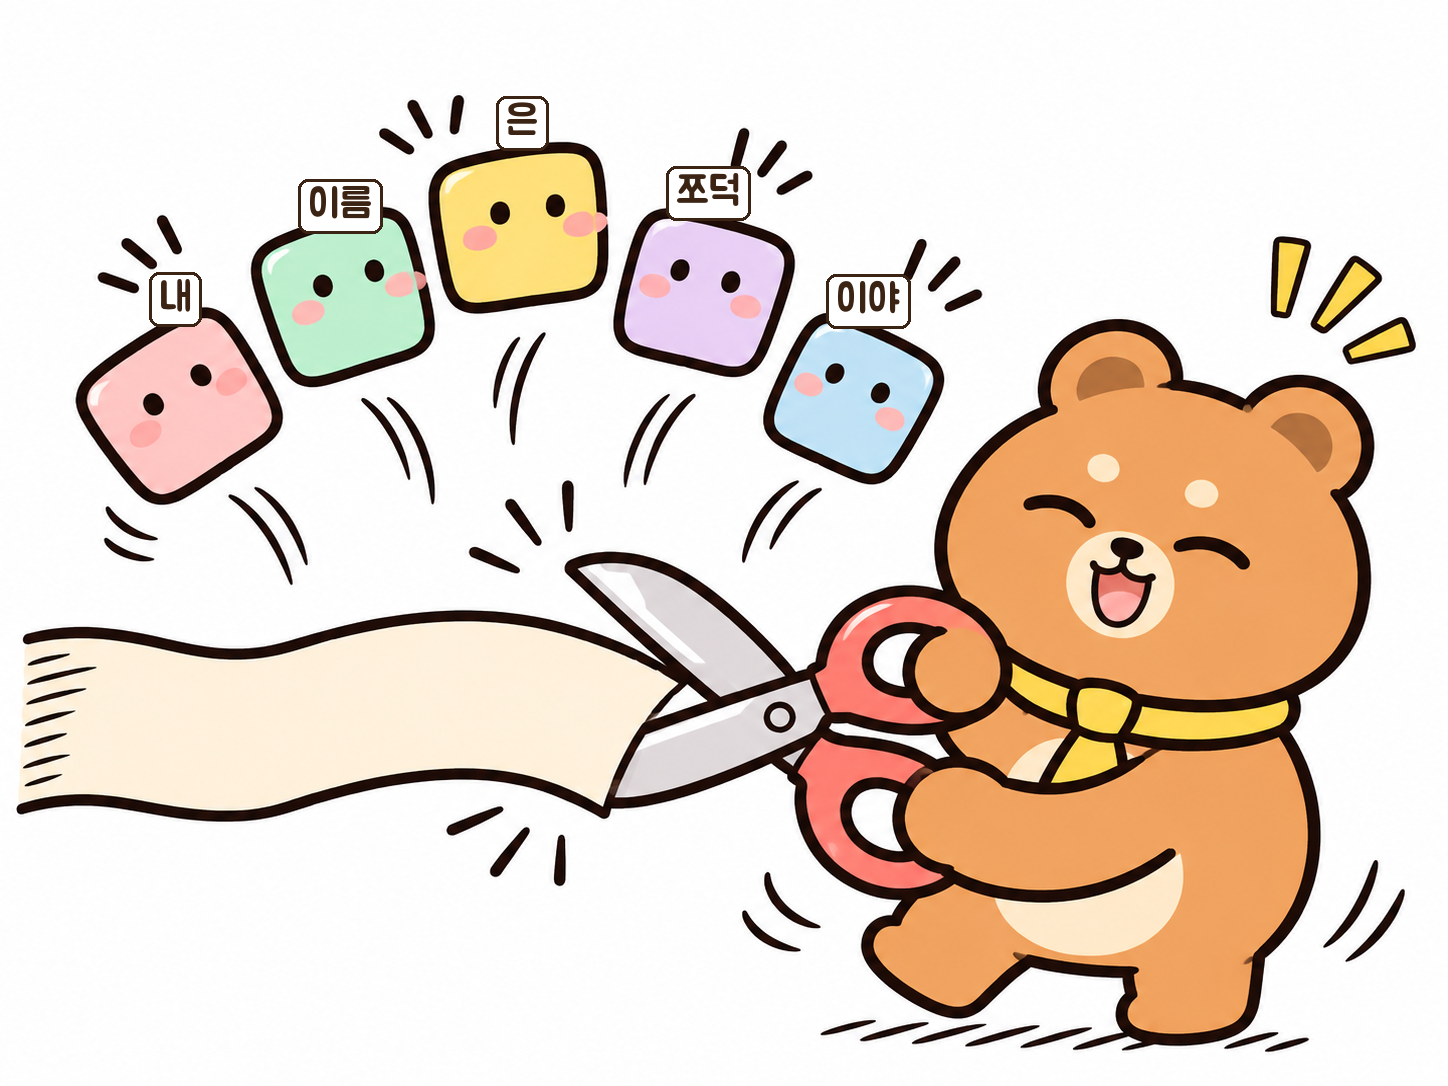
예를 들어 다음 문장을 보겠습니다.
"내 이름은 쪼덕이야"
이 문장을 [내] [이름] [은] [쪼덕] [이야]처럼 여러 조각으로 나누는 모습을 상상하면 됩니다.
물론 실제로는 모델마다 토큰을 나누는 방식이 다릅니다. 위의 예시는 원리를 이해하기 위한 것이고, 실제로 저렇게 잘린다는 뜻은 아닙니다.
OpenAI의 설명에 따르면 영어에서는 대략 1토큰이 4글자, 100토큰이 75단어 정도입니다.[3]
쪼덕: 그럼 책상을 엄청 큰 걸로 사 주면 되잖아!
문곰: 이미 엄청 커졌어.
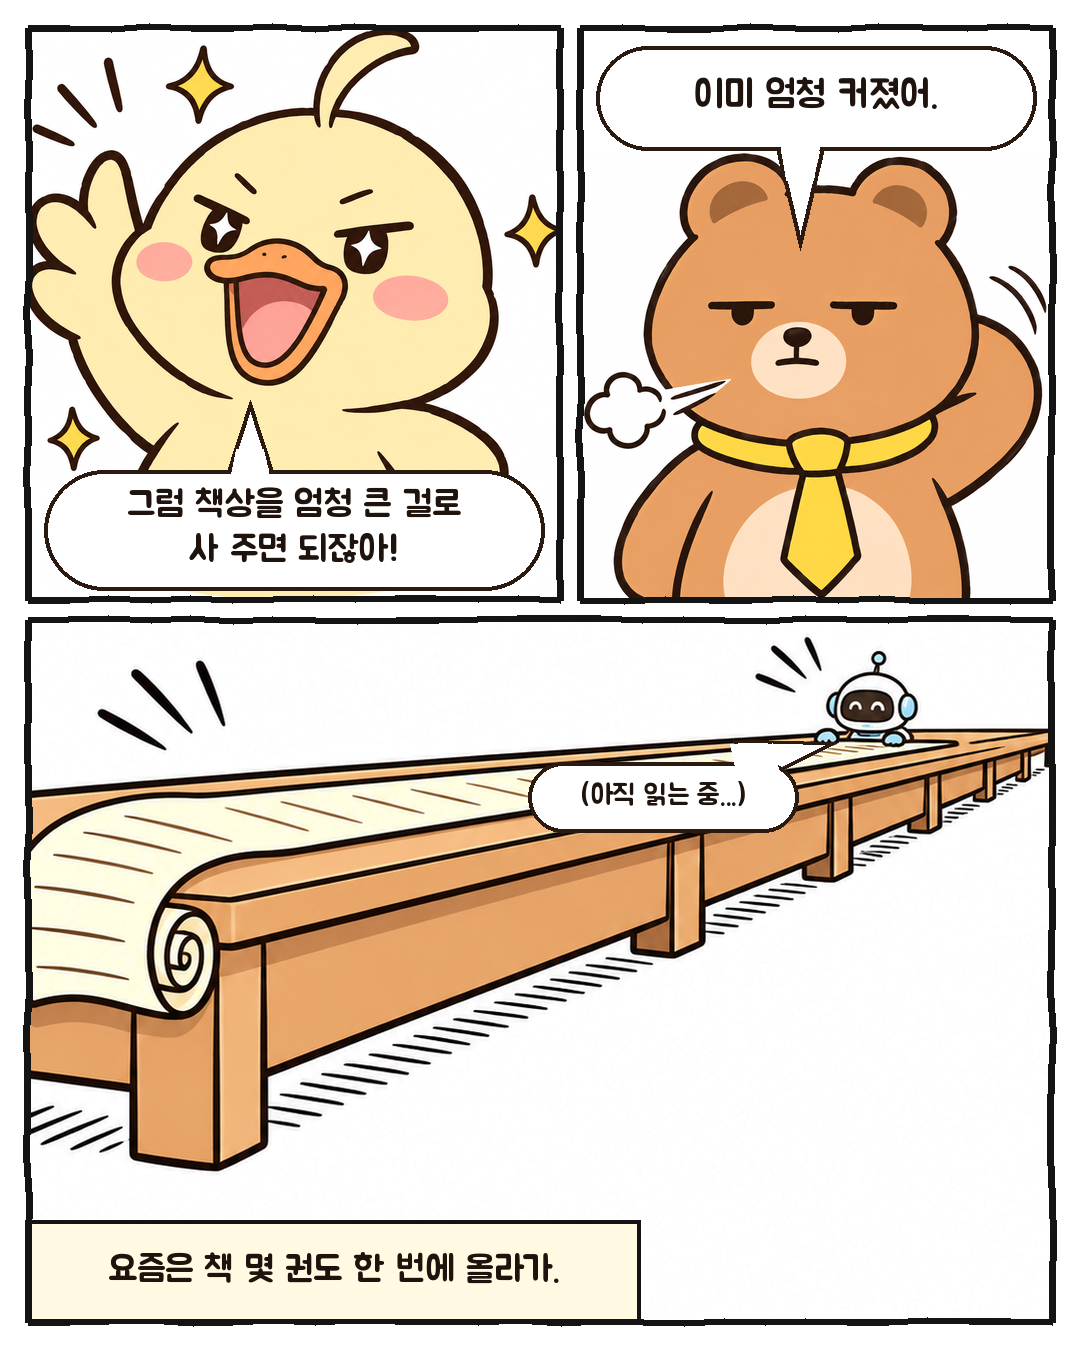
실제로 AI의 책상은 몇 년 사이 상당히 커졌습니다.
2024년 구글이 발표한 Gemini 1.5 연구에서는 수백만 토큰에 이르는 긴 맥락을 처리하는 능력을 보여 줬습니다.[4]
2026년 11월 기준 Claude의 일부 모델은 최대 100만 토큰의 컨텍스트 윈도우를 지원합니다.[2]
앞에서 소개한 영어 기준으로 단순히 계산하면 약 75만 단어에 해당합니다.
책 몇 권 분량의 텍스트를 한 번에 올릴 수 있는 크기죠.
물론 모든 AI가 이렇게 큰 책상을 가진 건 아닙니다. 같은 회사의 제품이라도 모델과 서비스에 따라 사용할 수 있는 크기가 다릅니다.
그리고 아무리 커도 끝은 있습니다.
2. AI가 대화를 까먹는 이유
2-1. 책상이 넘치면 어떻게 될까?
대화를 계속하다 보면 언젠가는 책상에 종이를 더 올릴 수 없는 순간이 옵니다.
그때 AI는 어떻게 할까요?
사실 이건 AI가 사용되는 서비스에 따라 다릅니다. 대표적인 방법 세 가지를 살펴보겠습니다.
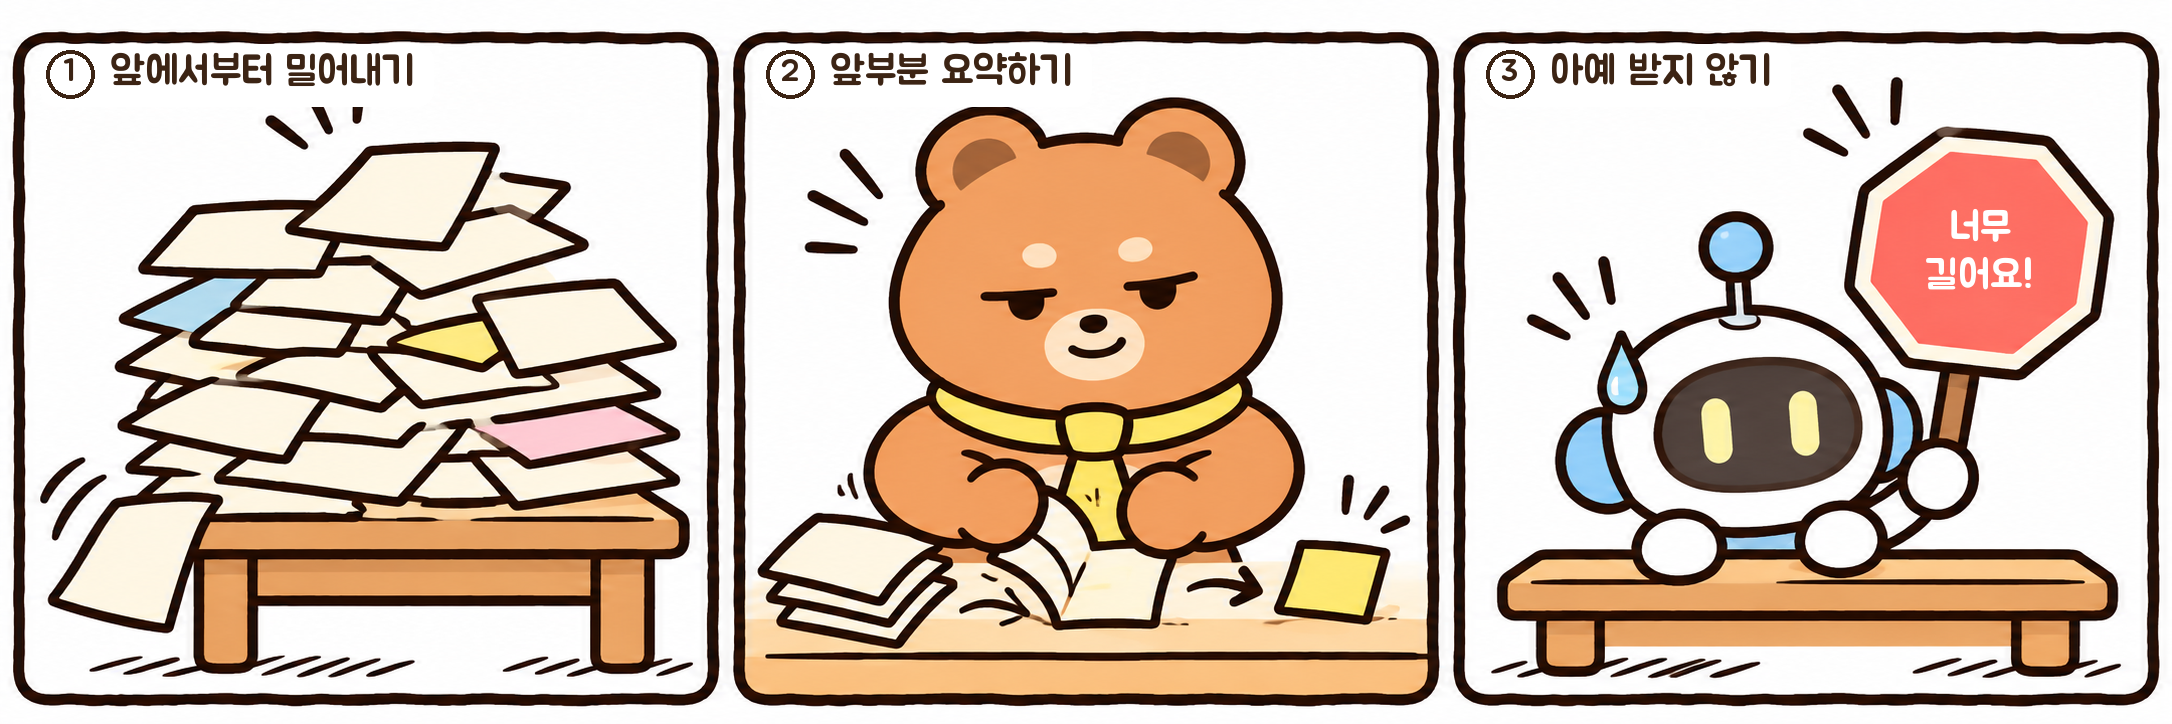
① 오래된 대화부터 빼기
가장 단순한 방법입니다.
책상이 꽉 차면 가장 오래된 종이부터 밖으로 내보냅니다.
먼저 들어온 것이 먼저 나간다고 해서 선입선출(First In, First Out)이라고 부릅니다.
Anthropic 문서에서도 Claude.ai와 같은 채팅 서비스가 이런 방식으로 컨텍스트를 관리할 수 있다고 설명합니다.[2]
예를 들어 쪼덕이가 처음에 알려 준 이름이 대화 맨 앞에 있었다면, 대화가 길어지면서 그 부분이 빠질 수도 있습니다.
② 오래된 대화를 요약하기
오래된 대화를 무조건 버리는 대신 짧게 요약하는 방법도 있습니다.
이를 컴팩션(Compaction)이라고 합니다.
종이 열 장에 적힌 내용을 한 장짜리 메모로 정리한다고 생각하면 됩니다.
이렇게 하면 책상 공간을 아끼면서도 중요한 내용을 어느 정도 유지할 수 있죠.
다만 요약에는 한계가 있습니다.
요약하는 과정에서 중요한 정보가 빠질 수도 있습니다. AI가 보기에는 별로 중요하지 않은 내용이 사용자에게는 꼭 필요한 정보일 수 있으니까요.
쪼덕이가 처음에 알려 준 이름도 이런 과정에서 빠질 가능성이 있습니다.
③ 아예 요청을 받지 않기
개발자가 AI 모델을 API로 직접 사용하는 경우에는 입력이 허용된 길이를 넘었을 때 오류가 발생하기도 합니다.
"프롬프트가 너무 깁니다."
이런 메시지를 받으면 개발자가 내용을 줄이거나, 요약하거나, 나눠서 처리하도록 수정해야 합니다.
이런 식으로 서비스마다 대화를 처리하는 방법이 다릅니다.
그럼 쪼덕이는 왜 이름을 잊힌 걸까요?
처음 알려 준 이름이 오래된 대화와 함께 빠졌을 수도 있고, 요약 과정에서 누락됐을 수도 있습니다.
다만 두 시간 동안 대화했다는 사실만으로 정확한 원인을 알 수는 없습니다.
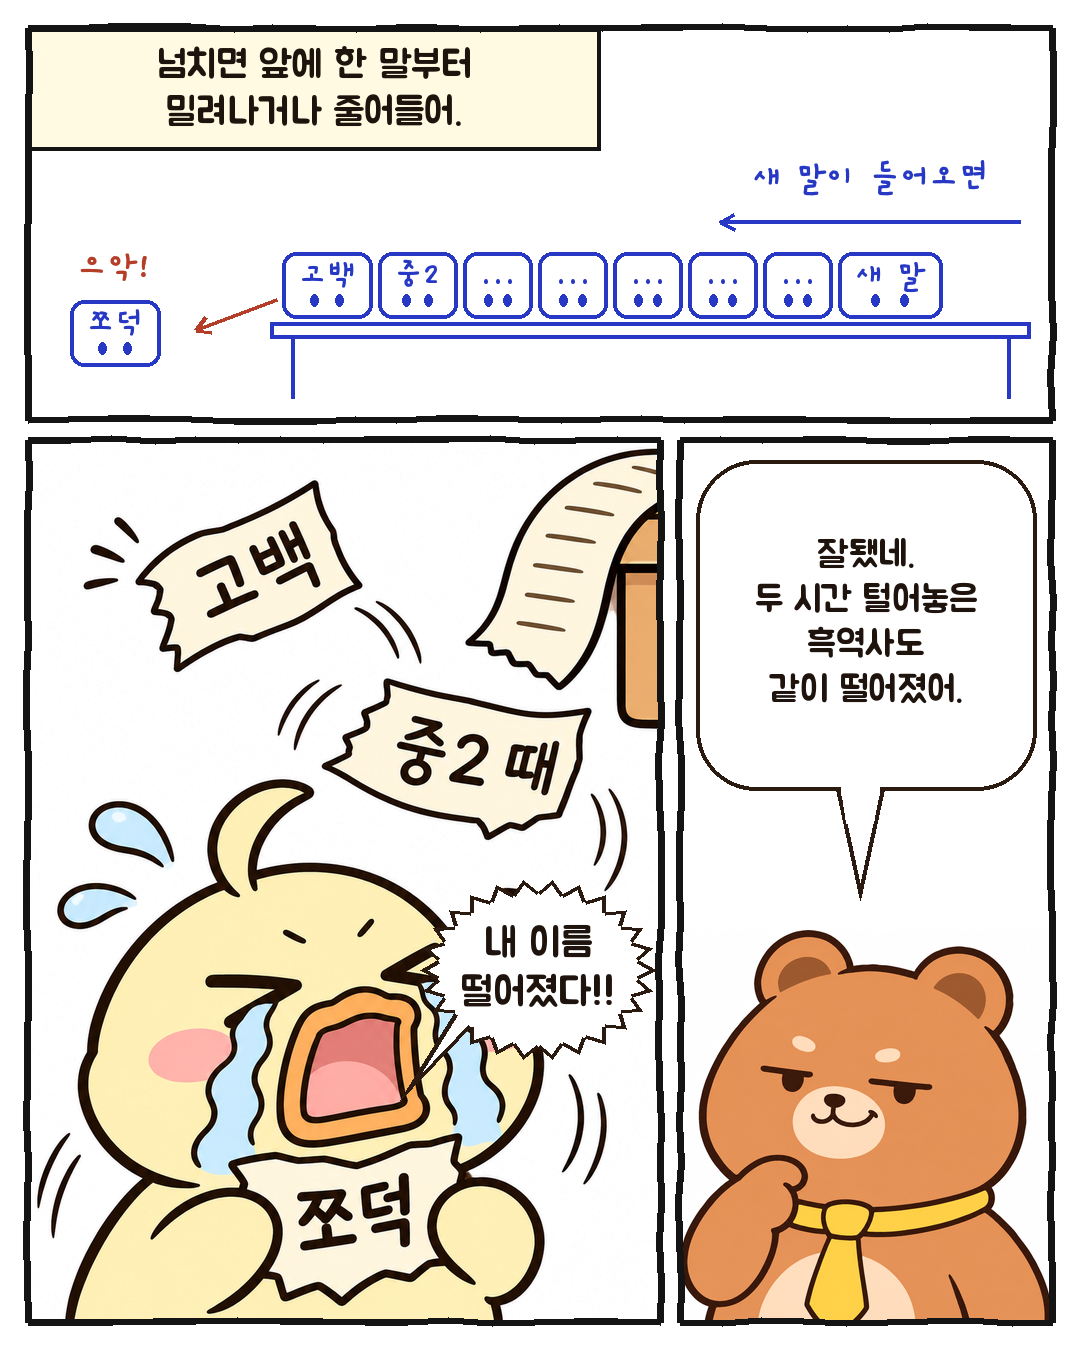
쪼덕: 내 이름 떨어졌다!!
문곰: 잘됐네. 두 시간 털어놓은 흑역사도 같이 떨어졌어.
만약 이름이 적힌 부분이 정말 책상 밖으로 떨어졌다면 어떨까요?
AI에게는 그 이름을 확인할 자료가 없는 셈입니다.
우리는 분명 처음에 말했다는 걸 기억하지만, AI가 지금 참고하는 기록에는 그 내용이 없을 수 있죠.
그래서 같은 채팅방에서 대화를 이어 가는데도 갑자기 처음 보는 사람처럼 행동하는 일이 생깁니다.
2-2. 책상이 커도 가운데는 흐릿하다
그렇다면 책상만 충분히 크면 이런 문제가 모두 해결될까요?
아쉽게도 그렇지는 않습니다.
책상 위에 종이가 올라가 있다고 해서 AI가 그 내용을 언제나 정확하게 찾아내는 것은 아니거든요.
2024년 발표된 Lost in the Middle이라는 연구에서 이 문제를 살펴봤습니다.[5]
연구진은 AI에게 여러 문서를 읽고 답을 찾게 하거나, 긴 목록에서 특정 정보를 찾아오게 했습니다.
여기까지는 평범한 실험인데, 한 가지 조건을 바꿨습니다.
정답이 들어 있는 위치를 바꾼 겁니다.
어떤 실험에서는 정답을 맨 앞에 놓고, 다른 실험에서는 가운데나 맨 뒤에 배치했습니다.
결과가 꽤 흥미로웠습니다.
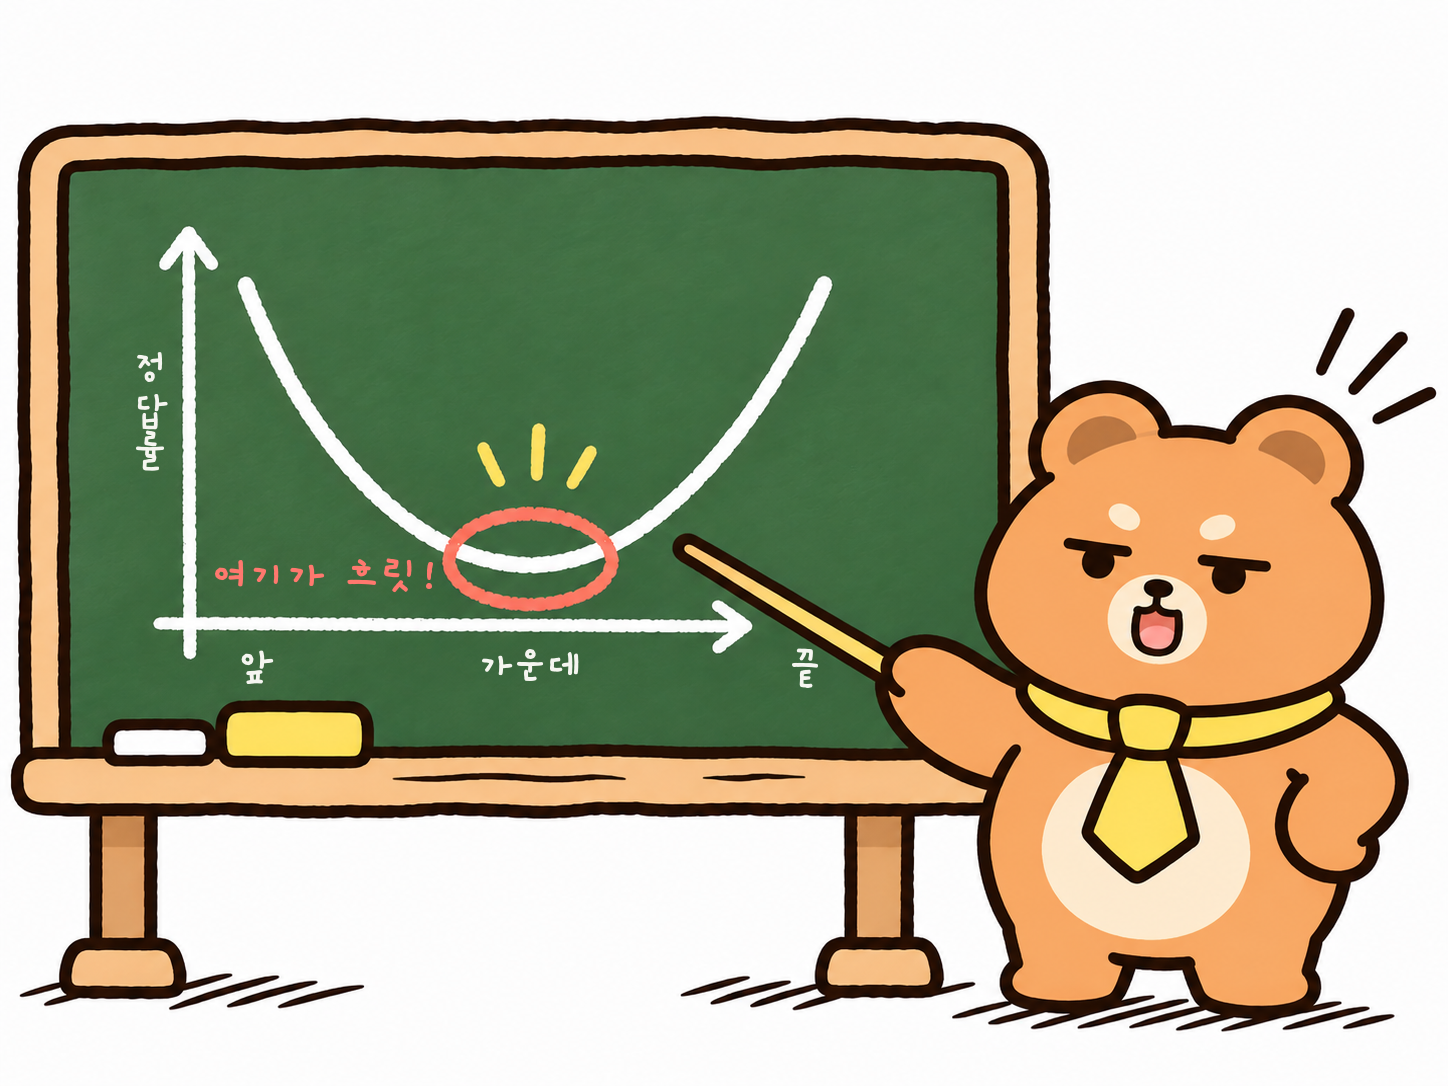
여러 모델에서 정답이 앞이나 뒤에 있을 때는 비교적 잘 찾아냈지만, 가운데에 있을 때는 성능이 크게 떨어지는 경향이 나타났습니다.
성능을 그래프로 그려 보면 양쪽 끝은 높고 가운데가 낮은 U자 모양이 됩니다.
연구진은 이 현상을 Lost in the Middle, 즉 '가운데에서 길을 잃는다'고 표현했습니다.
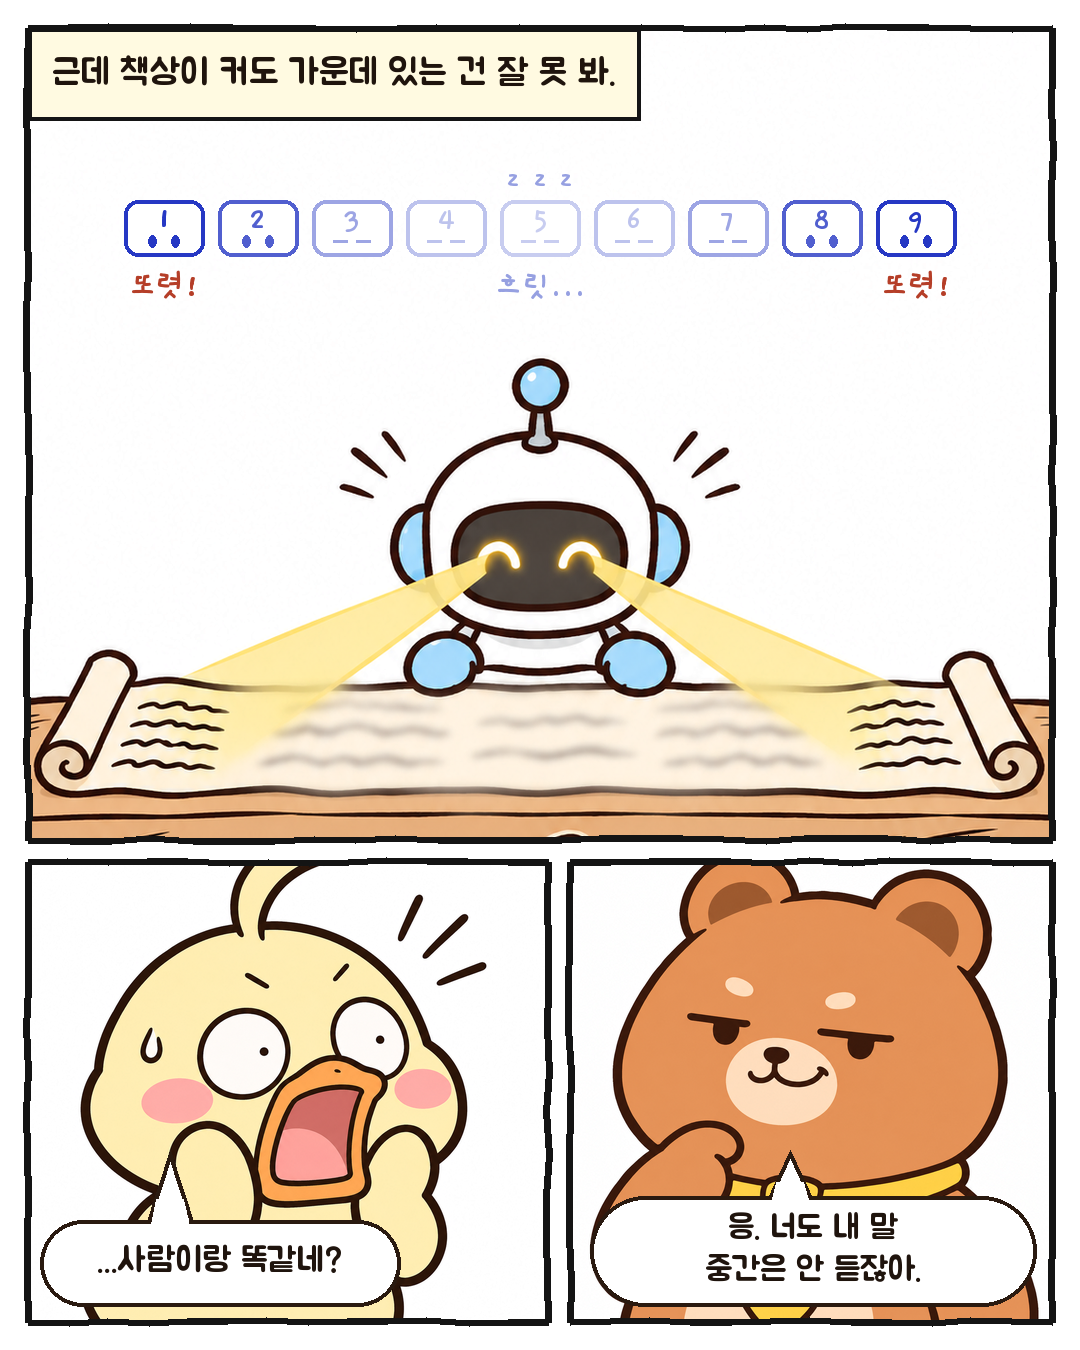
쪼덕: ...사람이랑 똑같네?
문곰: 응. 너도 내 말 중간은 안 듣잖아.
사람도 긴 이야기를 듣다 보면 중간에 들은 내용을 놓칠 때가 있잖아요.
AI에서도 비슷한 모양의 현상이 관찰된 겁니다.
물론 모든 모델이 언제나 U자 모양의 성능을 보이는 건 아닙니다. 모델과 과제에 따라 차이가 있습니다.
Anthropic에서는 긴 맥락을 처리할 때 정보 활용의 정확도가 떨어지는 문제를 컨텍스트 로트(Context Rot)라고 설명하기도 합니다.[2]
책상 크기만큼 중요한 게 책상 위에 무엇을 올리고, 그 정보를 얼마나 잘 활용하느냐는 거죠.
결국 대화 기록이 남아 있다고 해서 AI가 그 내용을 반드시 제대로 활용하는 것은 아닙니다.
긴 대화 중간에 한 번 알려 준 중요한 조건을 놓칠 수도 있다는 뜻입니다.
3. AI가 덜 까먹게 만드는 방법
3-1. 그럼 '메모리' 기능은 무엇일까?
쪼덕: 근데 내 친구 AI는 지난주에 한 말도 기억하던데?
맞습니다.
요즘 AI 채팅 앱에는 메모리(Memory) 기능이 있습니다.
새 대화를 시작했는데도 AI가 내 취향이나 예전에 했던 이야기를 알고 있는 경우가 있죠.
이건 앞에서 설명한 컨텍스트 윈도우와 어떻게 다를까요?
ChatGPT를 예로 들어 보겠습니다.
ChatGPT의 메모리 기능은 이전 대화에서 얻은 유용한 정보를 정리하거나, 과거 대화와 관련 자료에서 필요한 내용을 참고하는 방식으로 작동합니다.[6]
모델이 사람처럼 직접 경험을 떠올리는 것은 아닙니다.
서비스가 기억할 만한 정보를 관리하고, 필요할 때 AI가 다시 활용할 수 있도록 도와주는 겁니다.
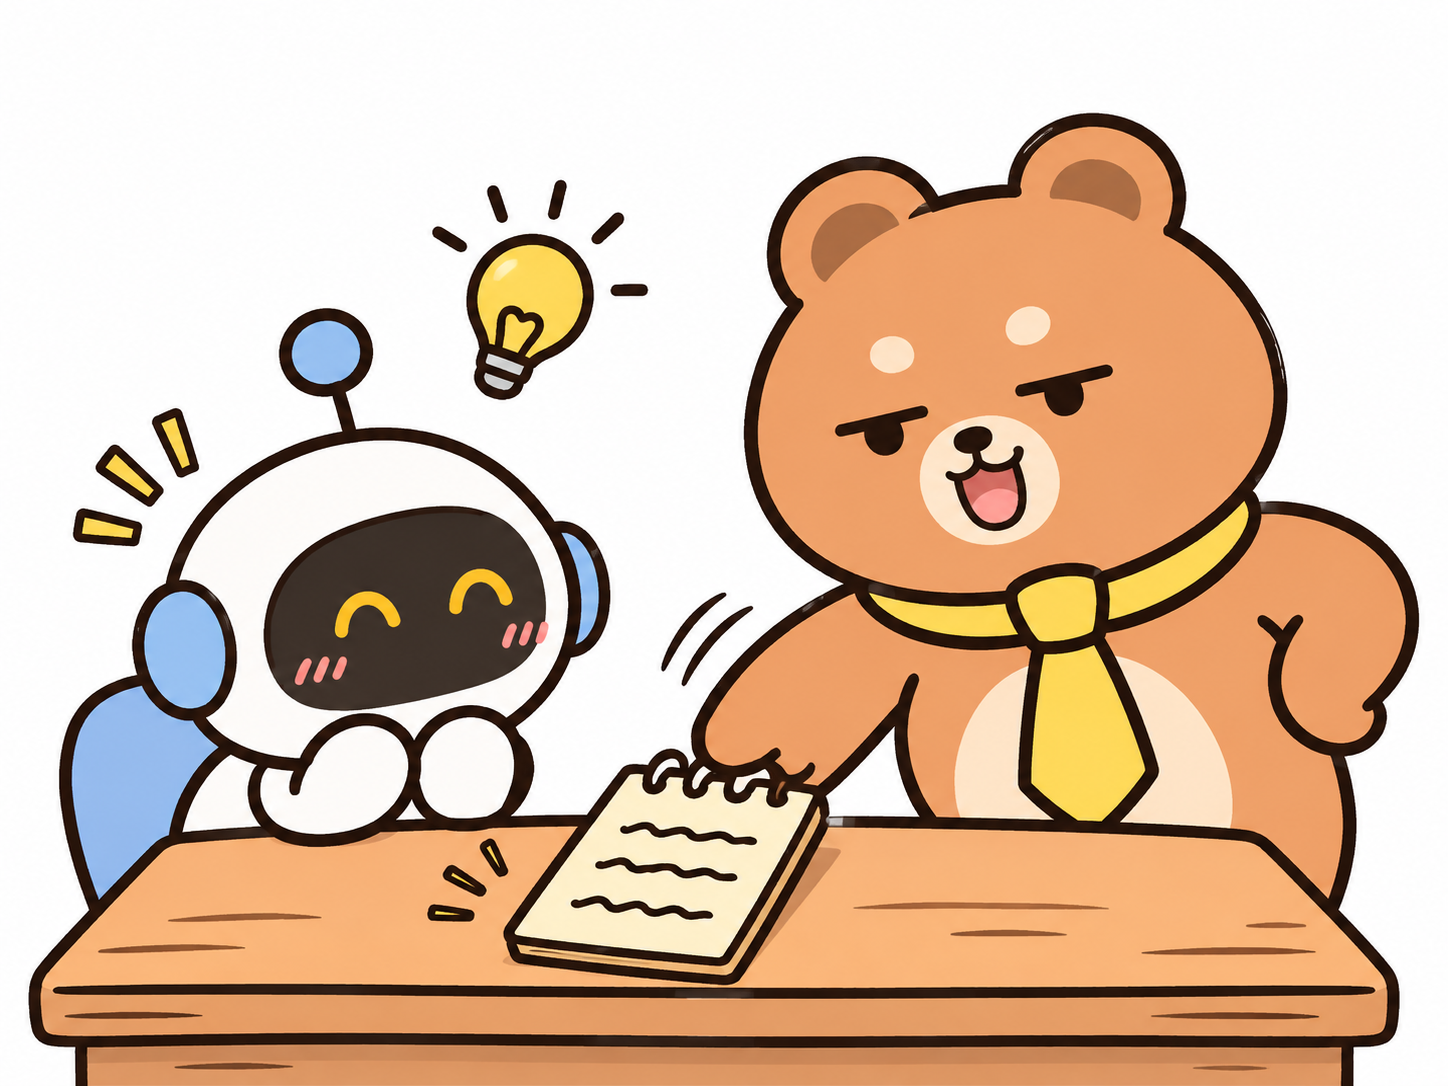
다시 책상으로 돌아가 봅시다.
평소에는 대화가 끝나면 책상 위의 종이를 치웁니다.
그런데 메모리 기능이 있다면 중요한 내용을 별도의 메모장에 정리해 둘 수 있습니다.
그리고 새 대화를 시작할 때 필요한 메모를 다시 꺼내 주는 거죠.
어떤 경우에는 예전에 나눈 대화에서 관련 내용을 찾아 참고하기도 합니다.
덕분에 매번 처음부터 모든 설명을 반복하지 않아도 됩니다.
그렇다고 메모리 기능이 모든 대화를 빠짐없이 기억하는 것은 아닙니다.
어떤 정보가 남고, 어떤 정보를 다시 참고할지는 서비스와 설정에 따라 달라집니다.
그래서 정말 중요한 내용이라면 메모리 기능에만 기대지 않는 편이 좋습니다.
3-2. AI에게 중요한 내용을 기억시키는 세 가지 방법
그럼 AI가 중요한 내용을 덜 놓치게 하려면 어떻게 해야 할까요?
쪼덕이는 나름대로 방법을 생각해 냈습니다.
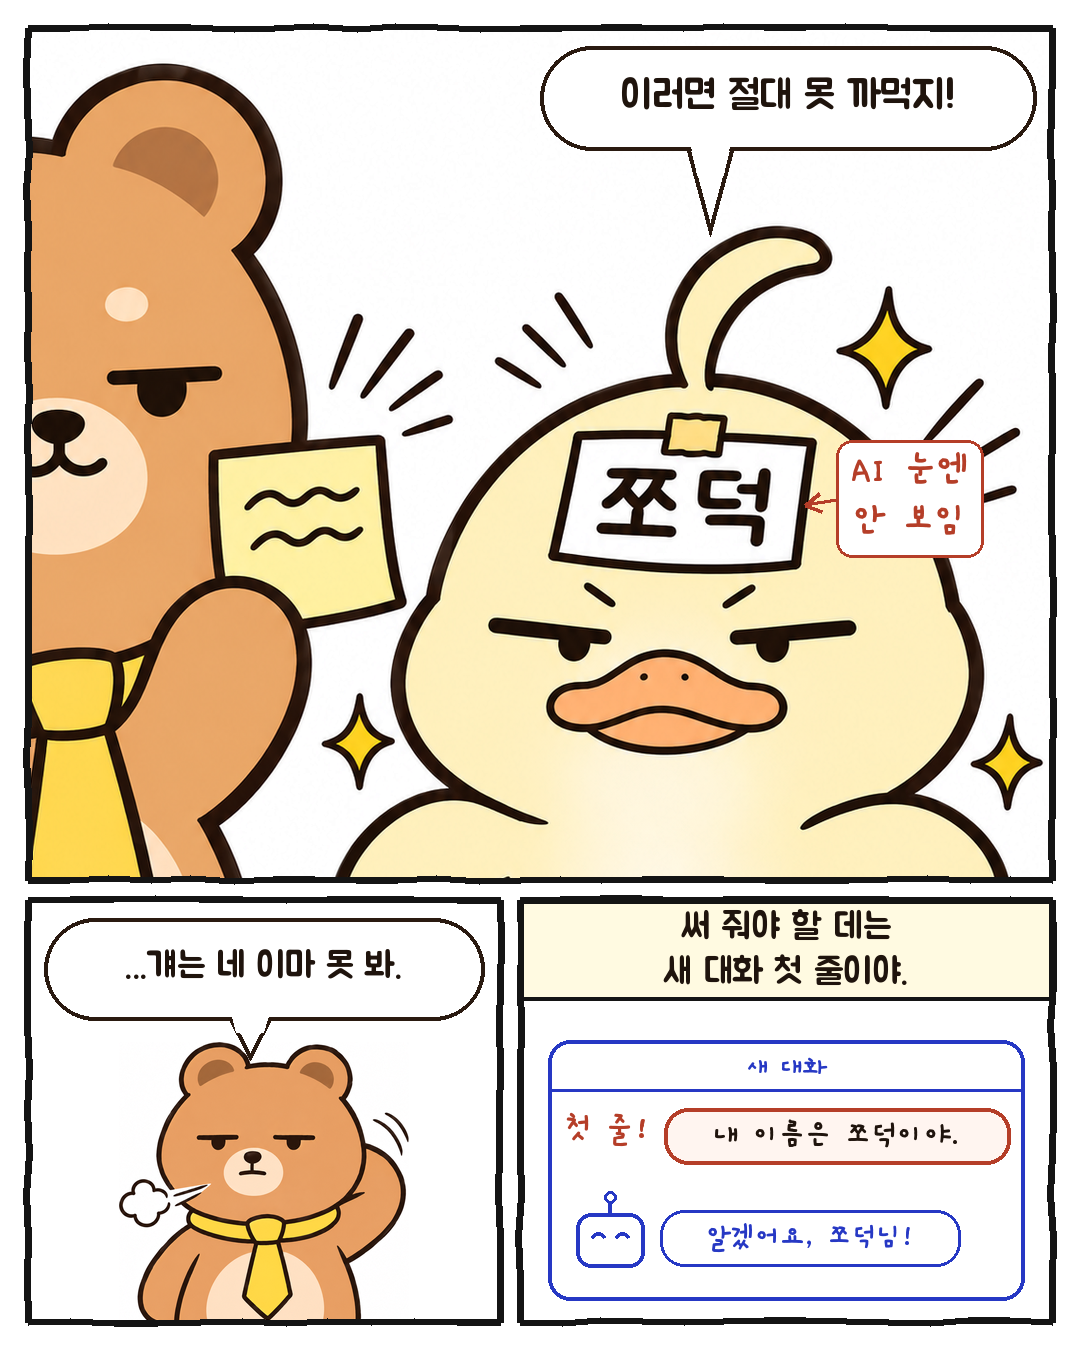
쪼덕: 이러면 절대 못 까먹지!
문곰: ...걔는 네 이마 못 봐. 써 줘야 할 데는 새 대화 첫 줄이야.
방향은 맞습니다.
중요한 내용을 AI가 참고할 수 있도록 분명하게 전달하는 것이 도움이 되니까요.
평소에 써먹기 좋은 방법 세 가지를 소개하겠습니다.
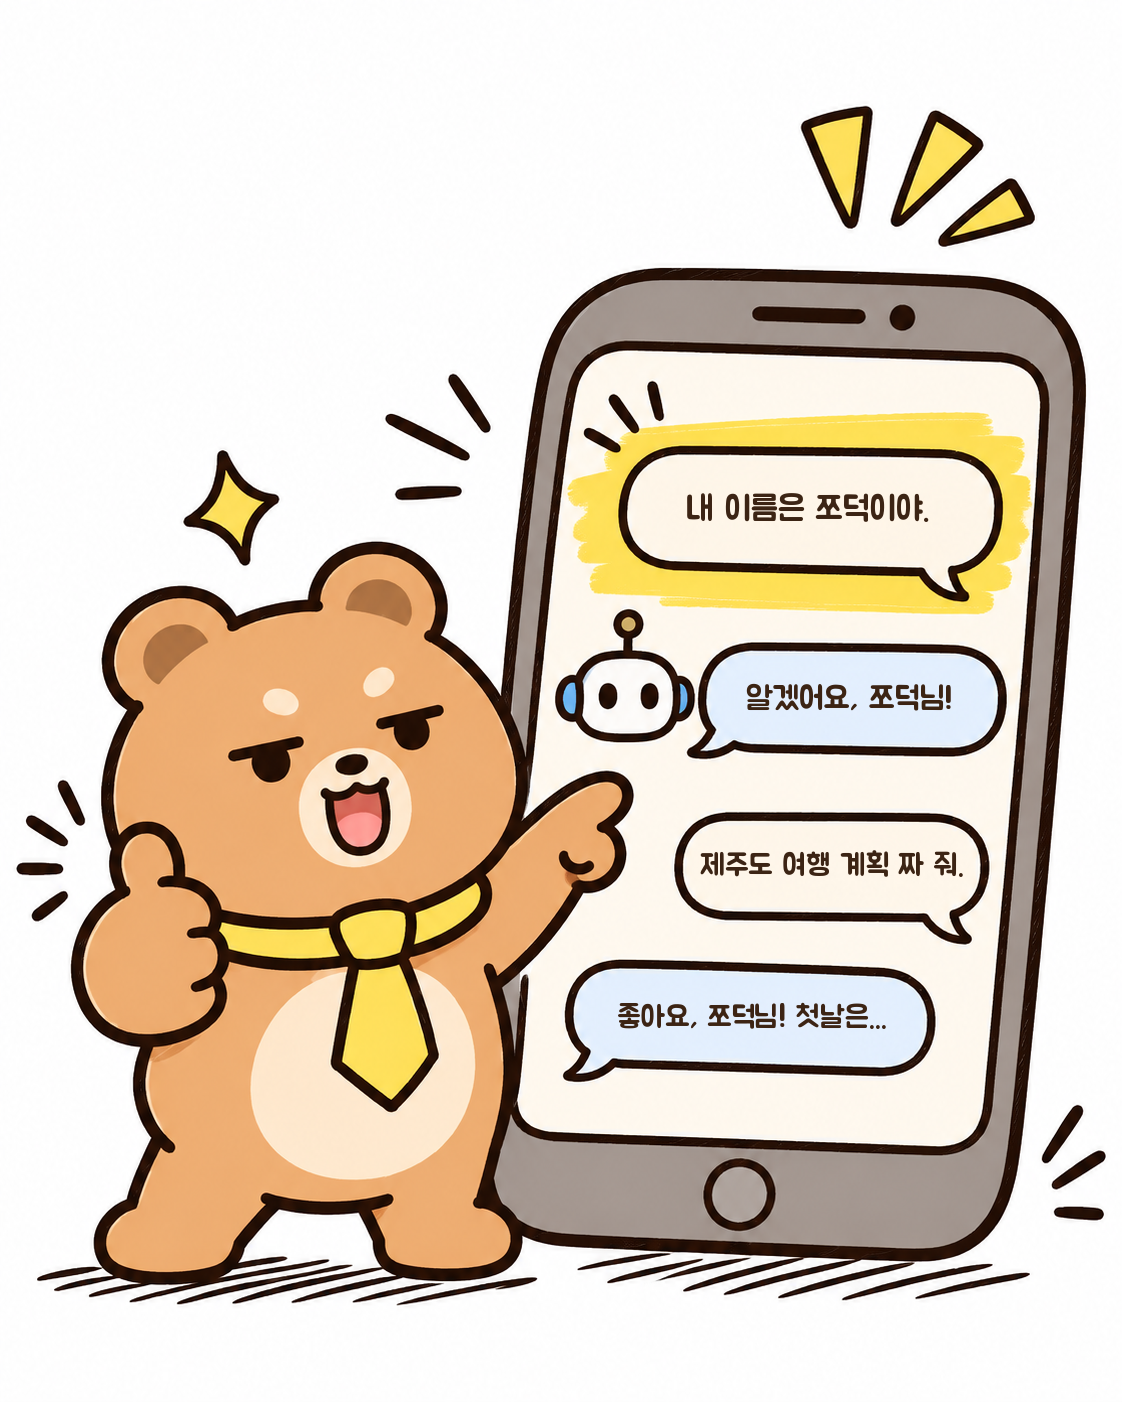
① 새 대화 첫 줄에 중요한 조건 적기
AI에게 무언가를 부탁할 때는 목적과 조건을 처음부터 알려 주는 게 좋습니다.
예를 들어 여행 계획을 짠다면 이렇게 시작할 수 있겠죠.
내 이름은 쪼덕이야.
이번에는 국내 여행 계획을 짜려고 해.
예산은 50만 원이고 비행기는 이용하지 않을 거야.
이 조건에 맞춰 여행지를 추천해 줘.
이렇게 하면 AI가 어떤 정보를 기준으로 답해야 하는지 알기 쉽습니다.
물론 맨 앞에 적는다고 해서 무조건 끝까지 기억되는 것은 아닙니다. 대화가 아주 길어지면 첫 메시지도 컨텍스트에서 빠질 수 있으니까요.
그래도 새로운 대화를 시작할 때 필요한 정보를 한꺼번에 알려 주는 건 좋은 방법입니다.
② 대화가 너무 길어지면 새 대화로 옮기기
하나의 채팅방에서 계속 질문하다 보면 대화 기록이 점점 길어집니다.
처음에는 여행 이야기만 하다가 숙소, 음식점, 교통편까지 한꺼번에 다루게 될 수도 있죠.
이럴 때는 지금까지 정한 내용을 정리해서 새 대화로 옮기는 방법이 있습니다.
예를 들어 AI에게 이렇게 부탁하면 됩니다.
지금까지 결정한 내용과 꼭 지켜야 할 조건을 다섯 줄로 정리해 줘.
AI가 정리한 내용이 맞는지 확인한 뒤 새 대화의 첫 메시지로 붙여 넣으면 됩니다.
책상 위에 쌓인 종이를 치우고 필요한 자료만 다시 올려놓는 셈입니다.
특히 긴 글을 쓰거나 여러 단계에 걸친 작업을 할 때 유용합니다.
③ 중요한 조건은 질문할 때 다시 말하기
앞에서 한 번 알려 준 내용이라도 꼭 지켜야 하는 조건이라면 다시 말해 주는 것이 좋습니다.
예를 들어 여행 예산을 처음에 알려 줬더라도 숙소를 추천받을 때는 이렇게 묻는 겁니다.
아까 정한 전체 예산 50만 원 안에서 숙소를 추천해 줘. 교통비도 남겨야 해.
조금 귀찮아 보여도 조건이 빠져서 엉뚱한 답을 받는 일을 줄일 수 있습니다.
특히 긴 문서를 분석하거나 여러 조건을 동시에 지켜야 하는 작업이라면 더 도움이 됩니다.
물론 이 세 가지 방법을 쓴다고 해서 AI가 절대 실수하지 않는 것은 아닙니다.
그래도 적어도 AI가 참고해야 할 정보를 놓치는 상황은 줄일 수 있겠죠.
문곰: 농담이야. 이마 말고 첫 줄에 쓰라니까.
쪼덕: ...첫 줄이 어디였더라?
4. 정리: AI의 기억은 사람과 다르다
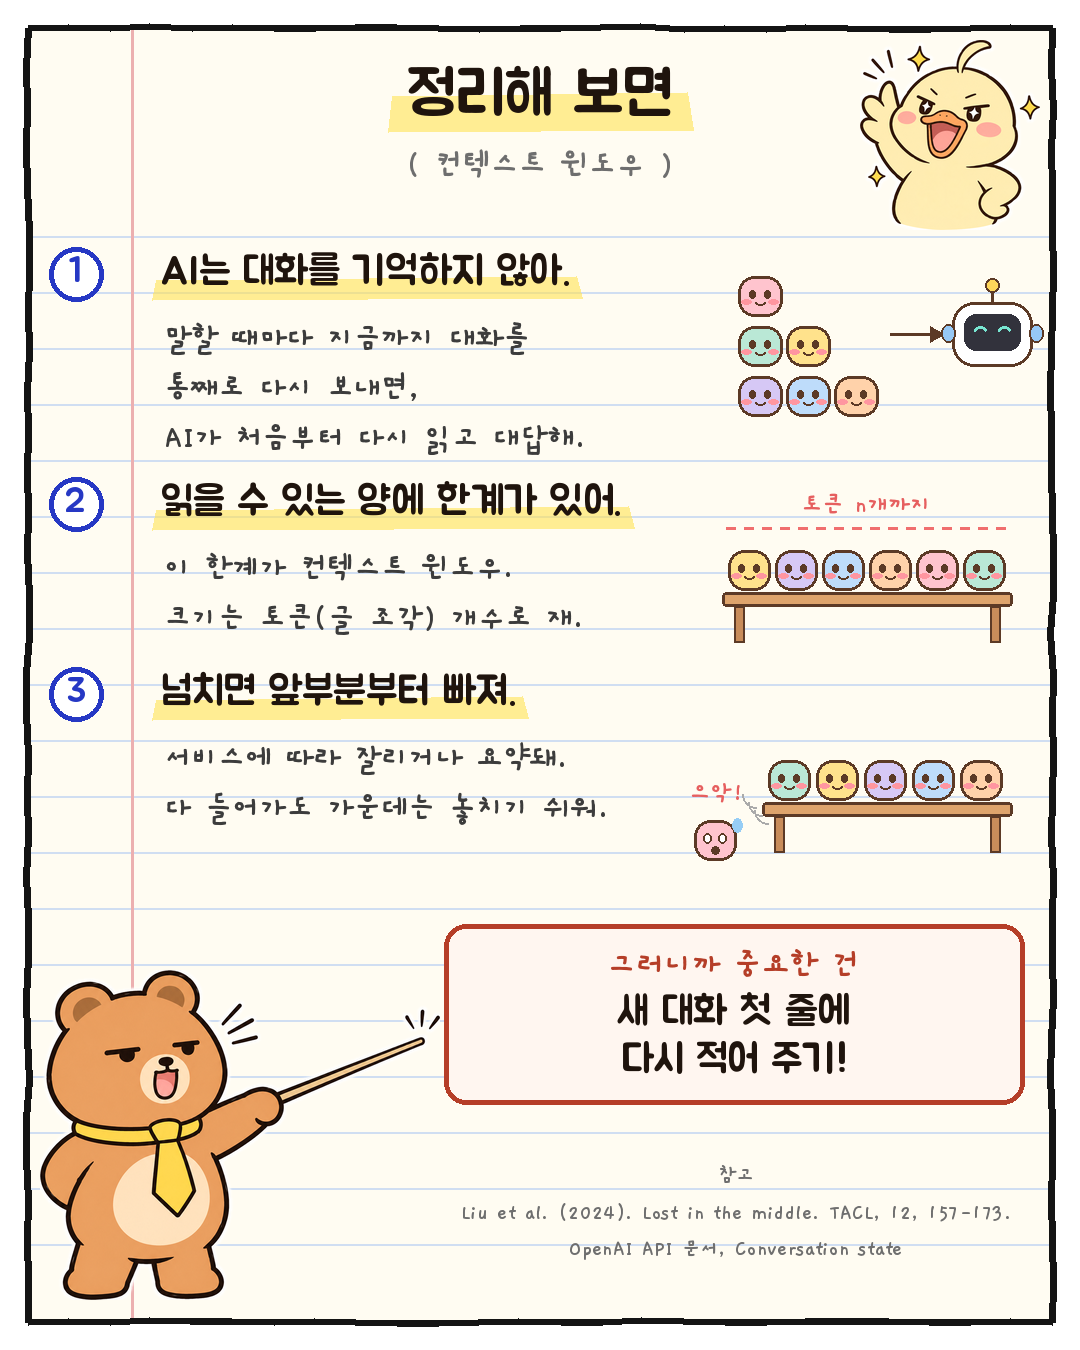
AI가 왜 이름을 까먹는지 알아봤습니다.
AI는 사람처럼 대화를 머릿속에 간직하지 않습니다. 대신 채팅 서비스가 전달해 주는 대화 기록과 여러 정보를 참고해 답변을 만듭니다.
이때 한 번에 참고할 수 있는 정보의 범위가 컨텍스트 윈도우입니다.
컨텍스트 윈도우에는 크기 제한이 있습니다. 대화가 길어지면 오래된 기록이 빠지거나 요약될 수 있고, 기록이 남아 있어도 AI가 필요한 내용을 제대로 찾아내지 못할 때가 있습니다.
메모리 기능이 이런 문제를 어느 정도 보완해 주지만, 모든 대화를 빠짐없이 기억하는 건 아닙니다.
그러니 AI가 중요한 내용을 자꾸 놓친다면 같은 말을 했다고 화내기보다는, 필요한 조건을 다시 알려 주는 편이 빠릅니다.
대화가 너무 길어졌다면 내용을 정리해서 새 대화로 옮기는 것도 좋은 방법이고요.
문곰과 쪼덕이의 다른 이야기는 인스타그램에서 볼 수 있습니다.
참고 자료
[1] OpenAI, Conversation State
https://developers.openai.com/api/docs/guides/conversation-state
[2] Anthropic, Context Windows
https://platform.claude.com/docs/en/build-with-claude/context-windows
[3] OpenAI, Understanding and Counting Tokens
https://help.openai.com/en/articles/4936856-understanding-and-counting-tokens
[4] Google, Gemini 1.5: Unlocking Multimodal Understanding Across Millions of Tokens of Context
https://arxiv.org/abs/2403.05530
[5] Liu et al. (2024), Lost in the Middle: How Language Models Use Long Contexts
https://aclanthology.org/2024.tacl-1.9/
[6] OpenAI, Memory in ChatGPT
https://help.openai.com/en/articles/8590148-memory-in-chatgpt
태그: 컨텍스트 윈도우, Context Window, 토큰, Token, LLM, ChatGPT, Claude, Lost in the Middle, AI용어, AI리터러시, 인공지능, 만화로 보는 AI