[AI][용어] 파인튜닝 vs RAG, 무엇이 다를까? AI에게 지식을 넣는 두 가지 방법
- IT/AI_용어
- 2026. 11. 22.
2026년 5월 8일, OpenAI가 짧은 공지를 하나 냈습니다. 파인튜닝 서비스를 접겠다는 내용이었습니다.[1]
새로 쓰려는 사람은 이제 쓸 수 없고, 원래 쓰던 사람도 길어야 2027년 1월 6일까지만 새로 학습시킬 수 있습니다.[2]
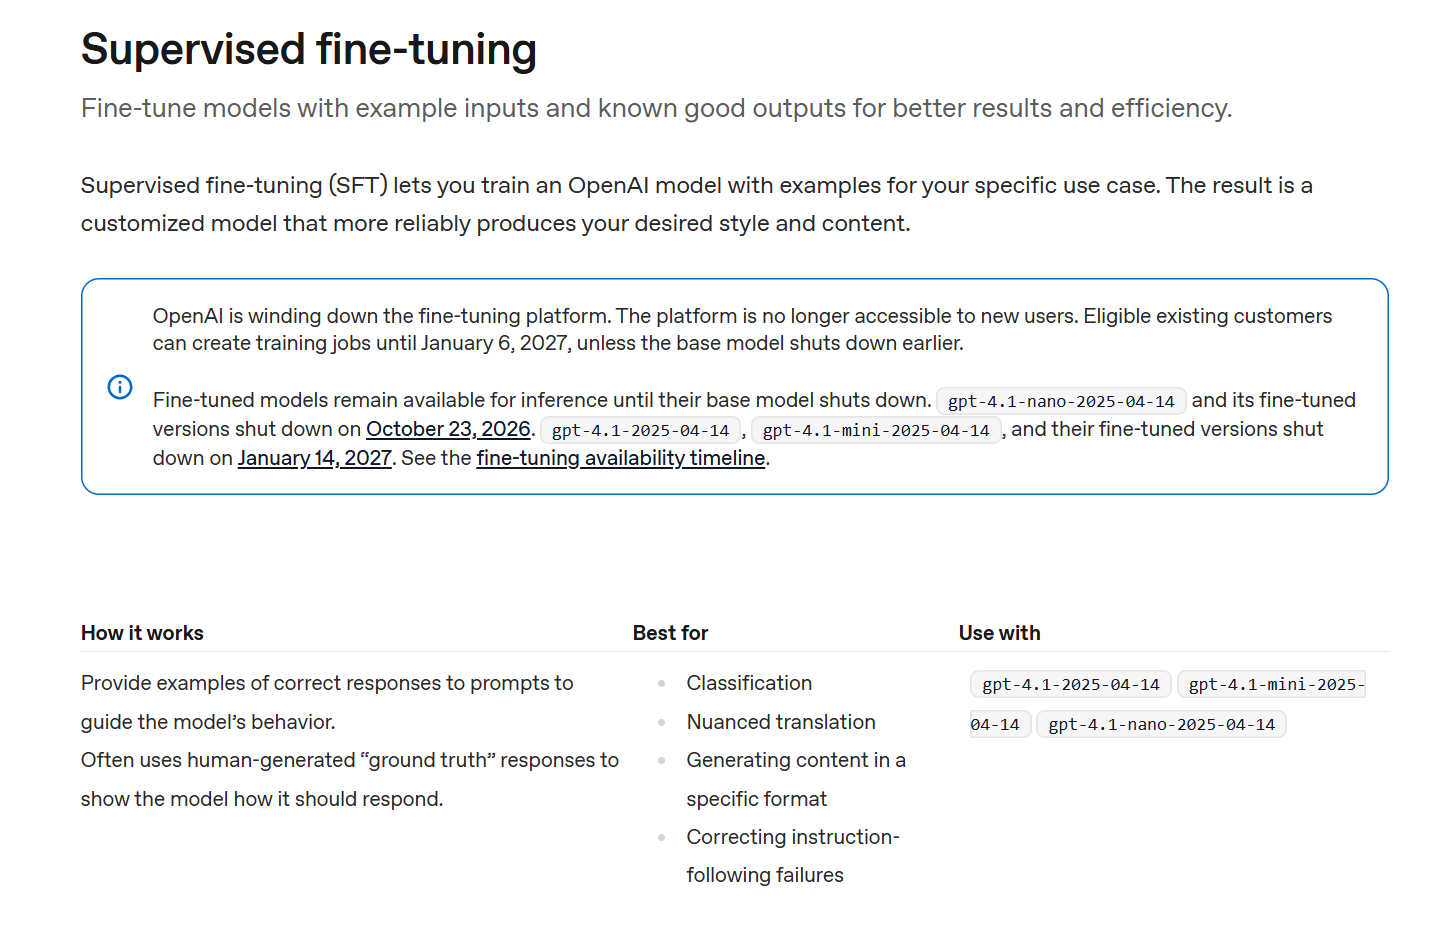
왜 접는지는 밝히지 않았습니다.
다만 OpenAI가 쓴 다른 안내 글에 눈에 띄는 문장이 있습니다. OpenAI가 도운 큰 회사들 중 상당수가 파인튜닝 없이 AI를 만들었다는 겁니다. 질문을 잘 쓰는 것(프롬프트)과 필요한 자료를 찾아 붙여 주는 것(RAG)만으로 말입니다.[3]
파인튜닝과 RAG는 둘 다 'AI에게 우리 일을 가르치는 방법'으로 자주 함께 소개됩니다. 하지만 방식은 전혀 다릅니다. 파인튜닝은 AI 자체를 다시 공부시키고, RAG는 AI 옆에 참고 자료를 펼쳐 놓습니다.
1. 파인튜닝은 모델 자체를 다시 가르치는 것
파라미터 글에서 AI가 배운 것은 결국 수많은 숫자, 즉 손잡이에 담겨 있다고 했습니다.
[AI][용어] 파라미터(Parameter)란? 'AI가 70B'라고 할 때 그 B의 정체
[AI][용어] 파라미터(Parameter)란? 'AI가 70B'라고 할 때 그 B의 정체
2019년, OpenAI가 GPT-2를 공개했습니다.[1]문장을 그럴듯하게 이어 쓰기는 했습니다만, 조금만 길어지면 티가 확 났습니다.했던 말을 또 하는 반복 현상이 자주 나타났고, 주제가 엉뚱한 데로 튀었습
www.gominq.com
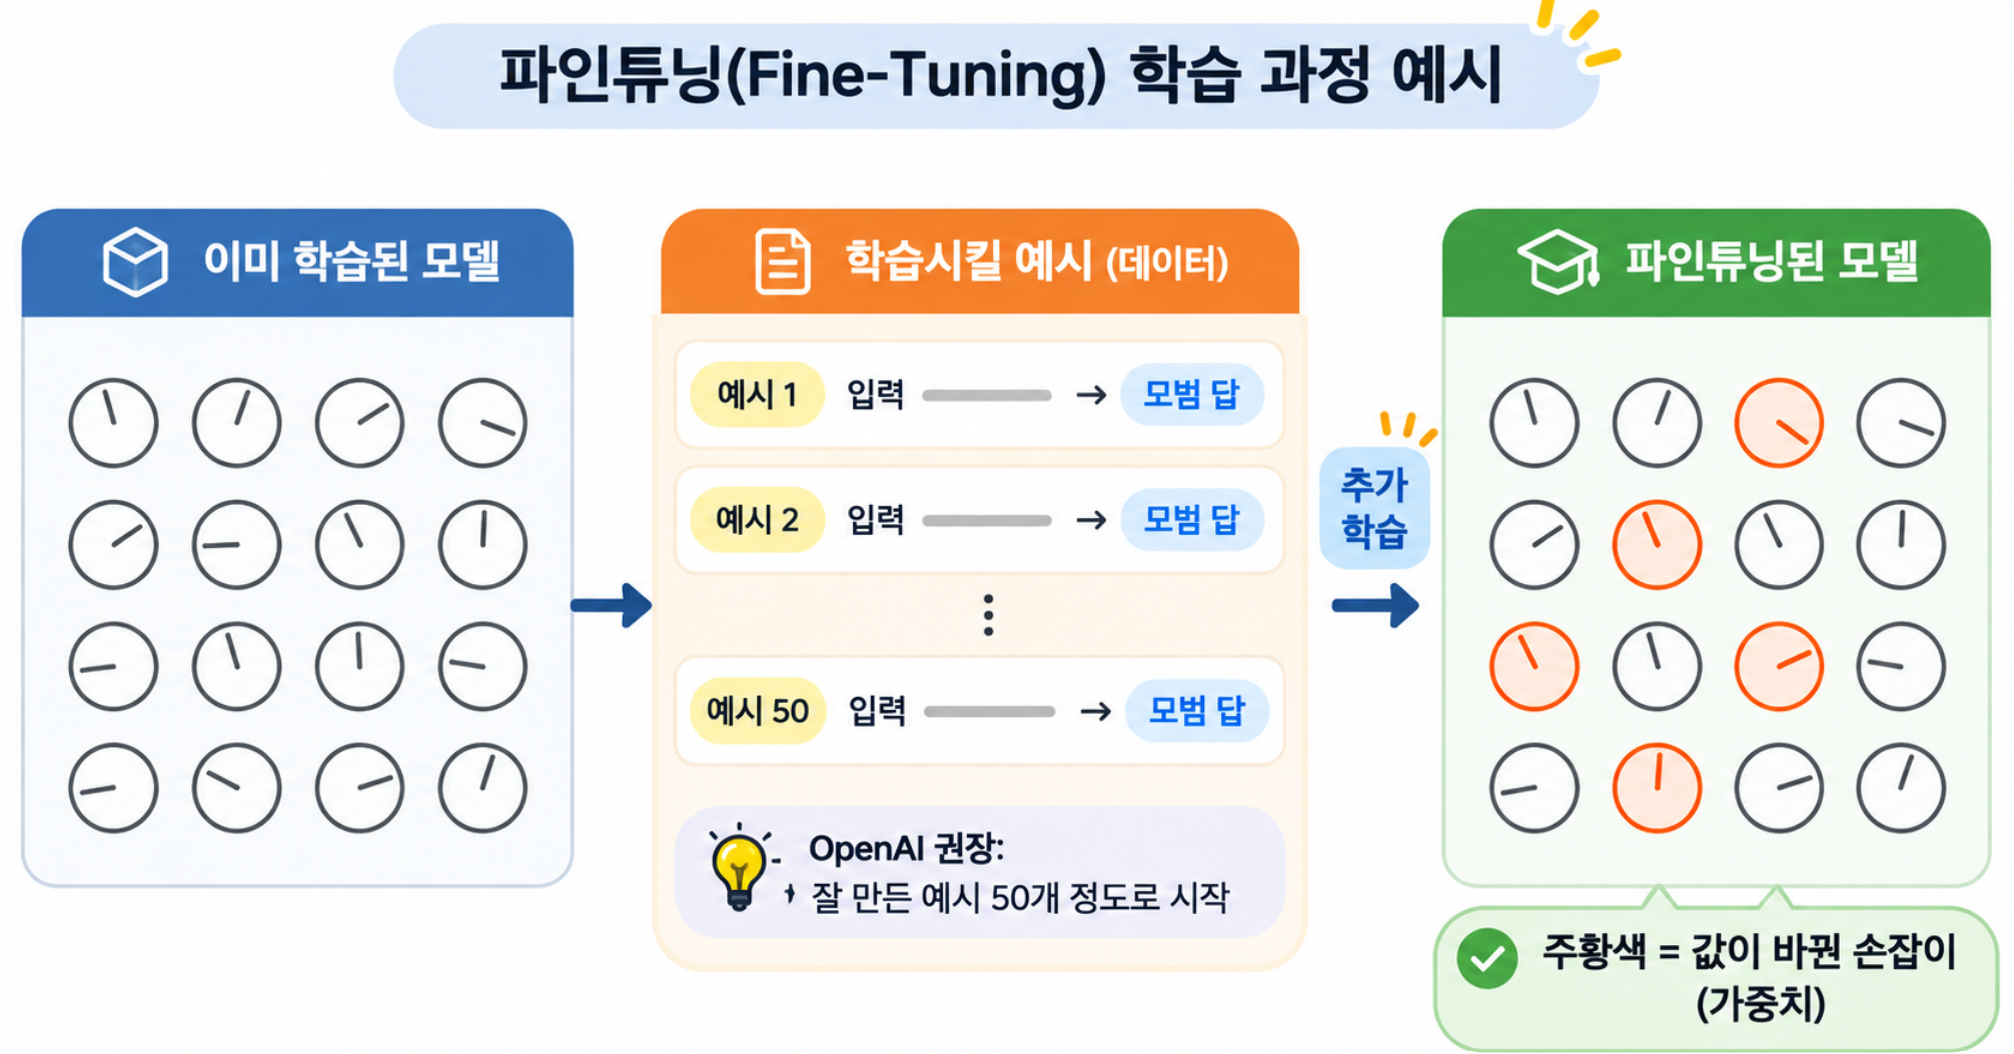
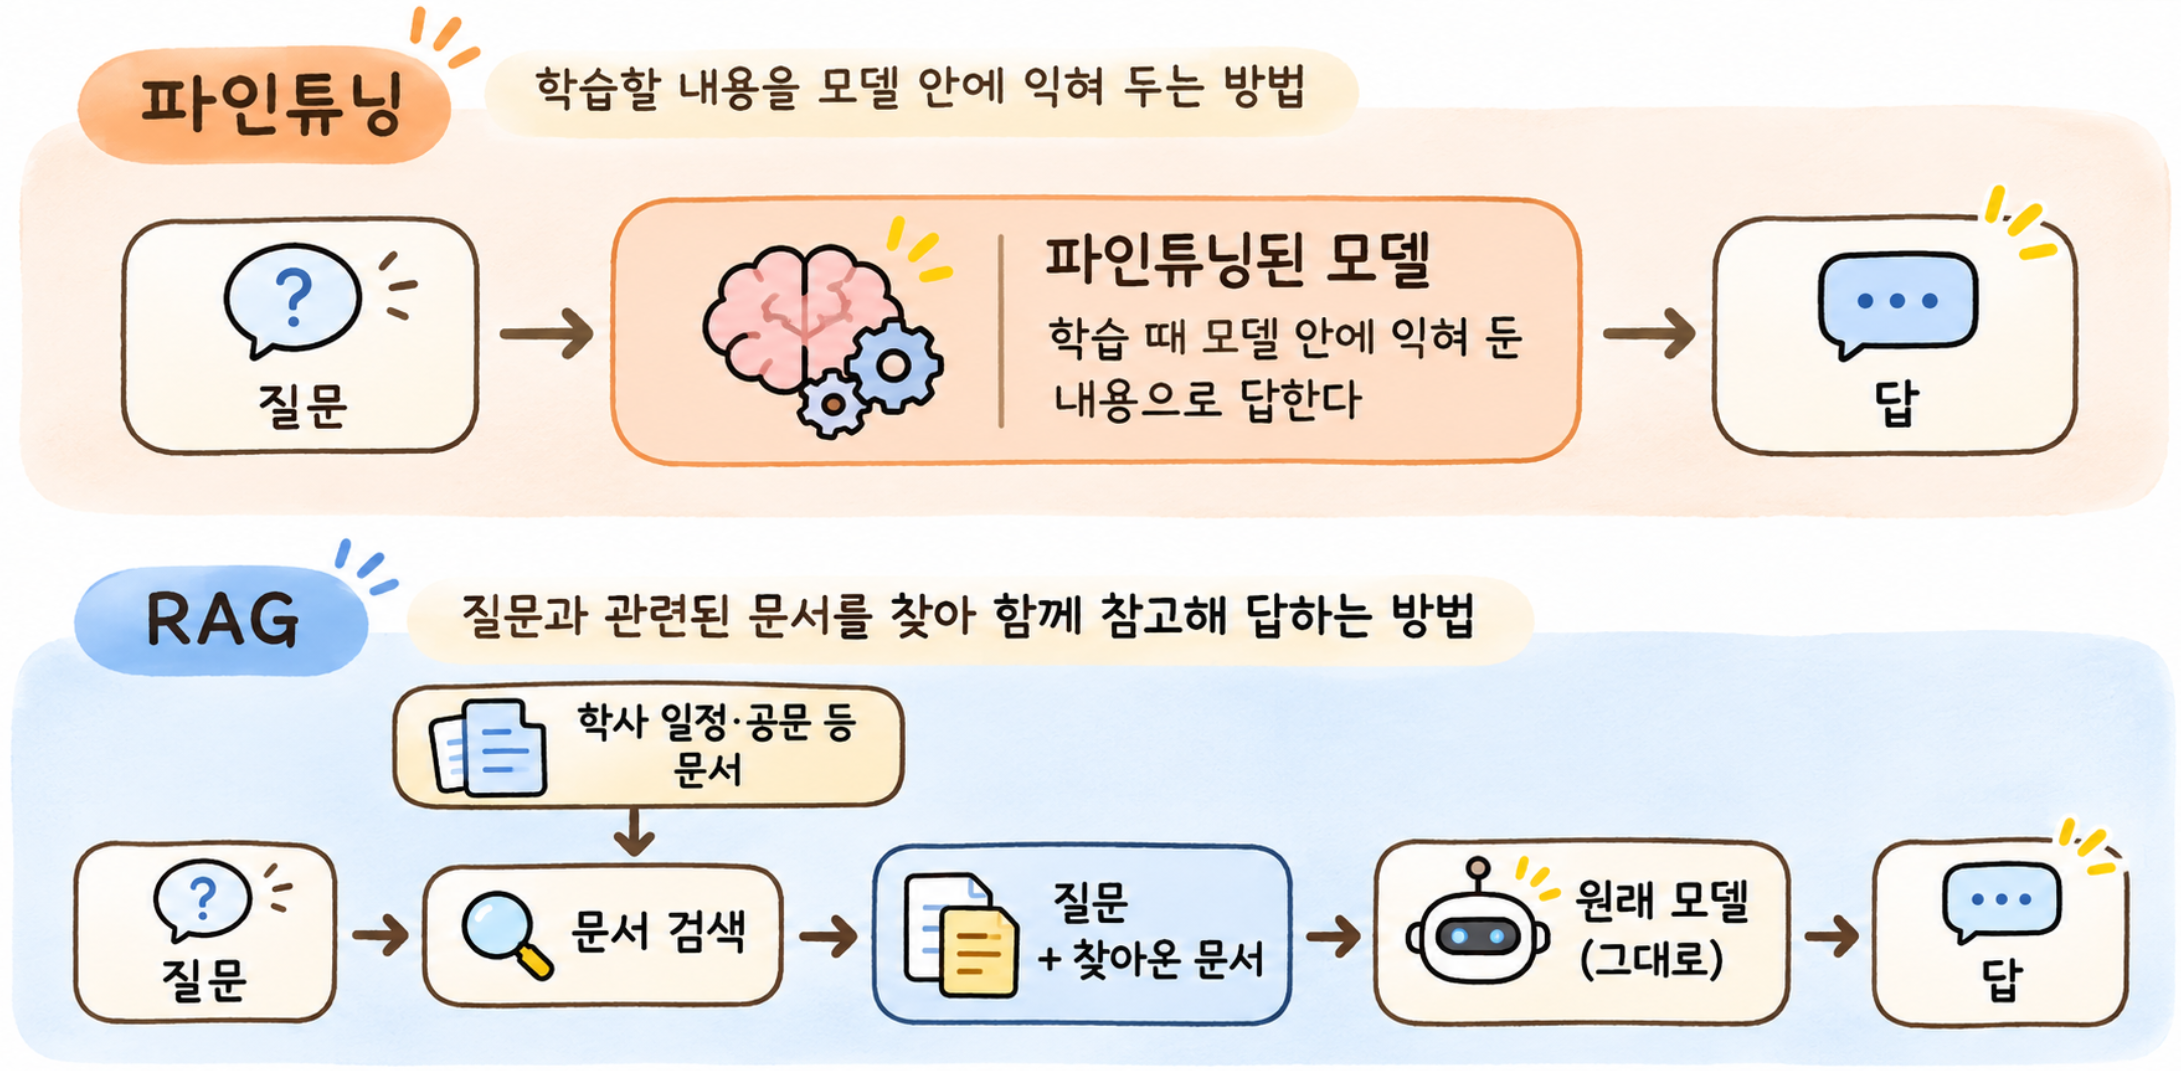
파인튜닝(Fine-tuning)은 이미 학습을 마친 모델에 예시를 더 보여 주면서 그 손잡이를 조금씩 다시 돌리는 일입니다.
"이런 입력에는 이렇게 답한다"는 예시를 여러 개 준비해서 더 학습시키는 식이죠. OpenAI도 파인튜닝을 예시 입력과 잘 쓴 답을 보여 주어, 원하는 문체와 내용을 더 안정적으로 내놓는 맞춤 모델을 만드는 방법으로 설명합니다.[2]
예시가 엄청나게 많이 필요한 건 아닙니다. OpenAI는 우선 잘 만든 예시 50개 정도로 시작해 보고, 결과에 따라 늘리라고 권합니다.[2][3]
학습이 끝나면 모델의 가중치, 즉 손잡이 값이 달라집니다. 그래서 질문할 때마다 학습에 썼던 예시를 다시 보여 줄 필요가 줄어듭니다.
2. RAG는 모델은 그대로 두고 자료를 옆에 놓는 것
RAG(Retrieval-Augmented Generation)는 반대입니다. 모델의 손잡이는 건드리지 않습니다.
대신 질문이 들어올 때마다 관련 자료를 먼저 찾아서, 그 내용을 답에 넣도록 모델에게 함께 건넵니다.[4]
RAG란? AI가 최신 정보를 아는 방법
여러 분 혹시 예전에 ChatGPT한테 오늘 뉴스를 물어본 적 있으신가요?물어보면 대부분 "해당 정보를 알 수 없습니다"라는 답을 받게 됩니다.그런데 최근 AI 서비스는 최신 뉴스도 알고, 우리 회사
www.gominq.com
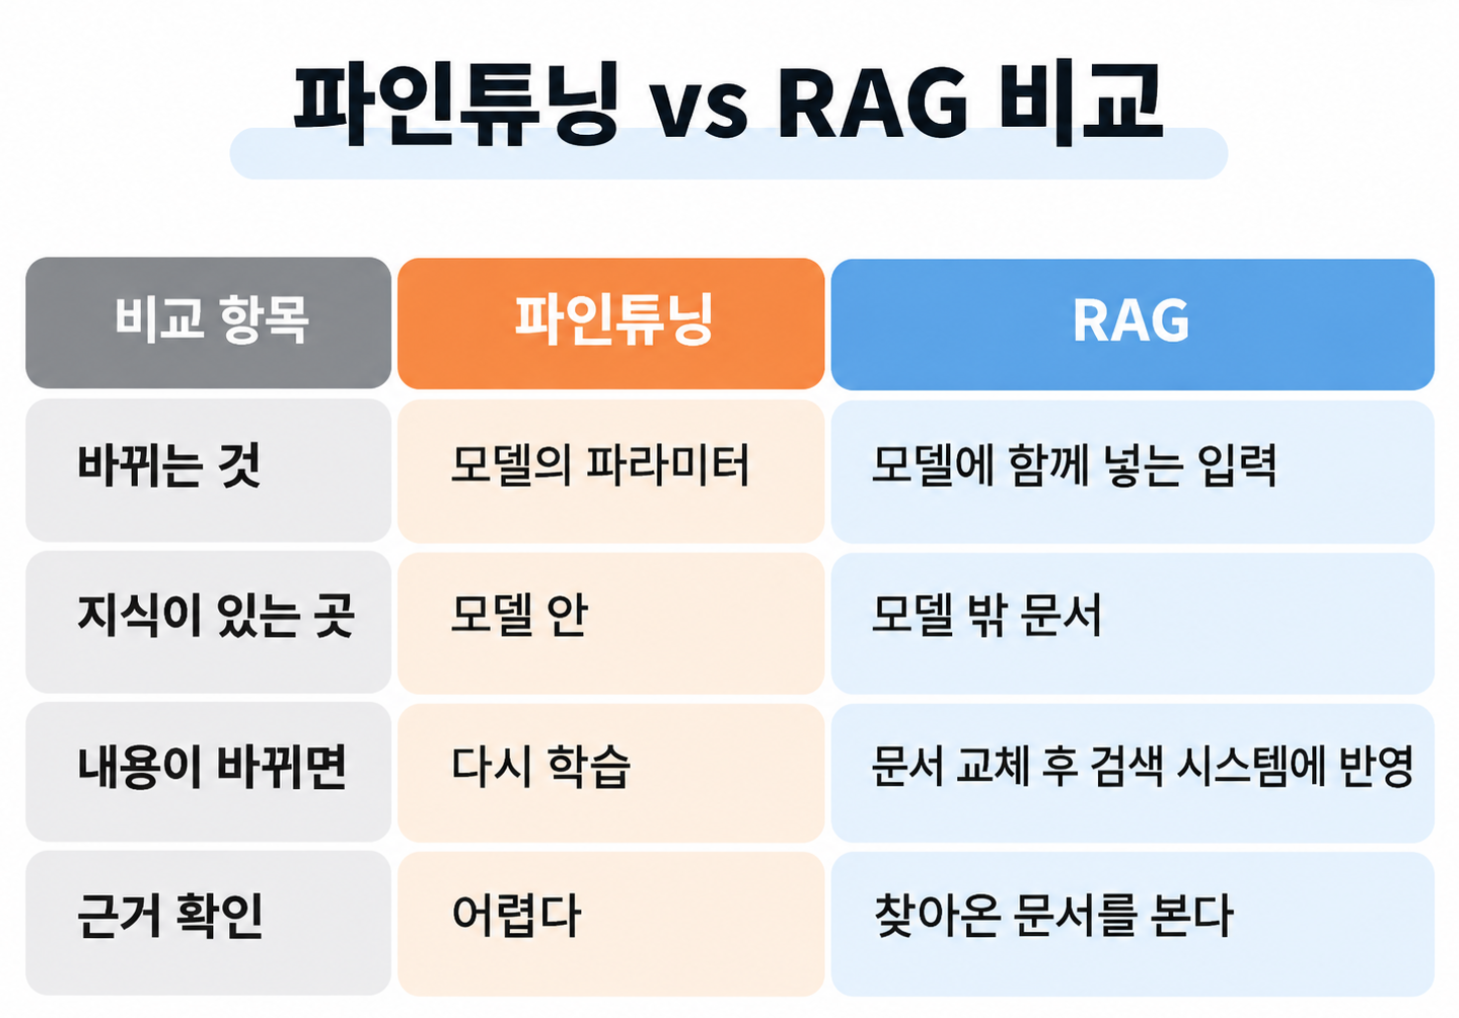
그래서 RAG는 문서를 바꾸고 검색 시스템에 반영하면 새 내용을 활용할 수 있습니다. 반면 파인튜닝으로 익힌 내용을 모델 안에서 바꾸려면 추가 학습이 필요합니다.
답의 근거를 확인하는 일도 다릅니다. RAG는 찾아온 문서를 그대로 보면 되지만, 파인튜닝한 모델은 어느 예시에서 배운 내용인지 바로 확인하기 어렵습니다.
3. 새로운 지식을 넣을 때는 어느 쪽이 나을까?
2023년 말 마이크로소프트 연구진은 이 차이를 시험 보는 대학생 세 명에 빗댔습니다.[4]
한 학생은 시험 전에 미리 공부합니다. 파인튜닝입니다.
다른 학생은 공부는 못 했지만 시험 중에 교과서를 펼쳐 볼 수 있습니다. RAG입니다.
마지막 학생은 아무것도 없이 시험을 봅니다. 원래 모델 그대로죠.
연구진은 이걸 실제로 확인했습니다. Llama2, Mistral, Orca2 세 모델(모두 7B)에게 2023년 8~11월에 있었던 미국 시사 문제 910개를 풀게 한 겁니다. 모두 세 모델이 학습을 끝낸 뒤의 일이라, 학습 중에 접하지 않았을 가능성이 큰 지식입니다.[4]
참고로 이 연구의 파인튜닝은 1장에서 설명한 방식과 조금 다릅니다. 질문과 모범 답변을 짝지어 보여 주는 대신, 관련 문서의 텍스트 자체를 추가로 학습시켰습니다. 이런 방식을 비지도 파인튜닝이라고 합니다.[4]
결과는 이랬습니다.[4]
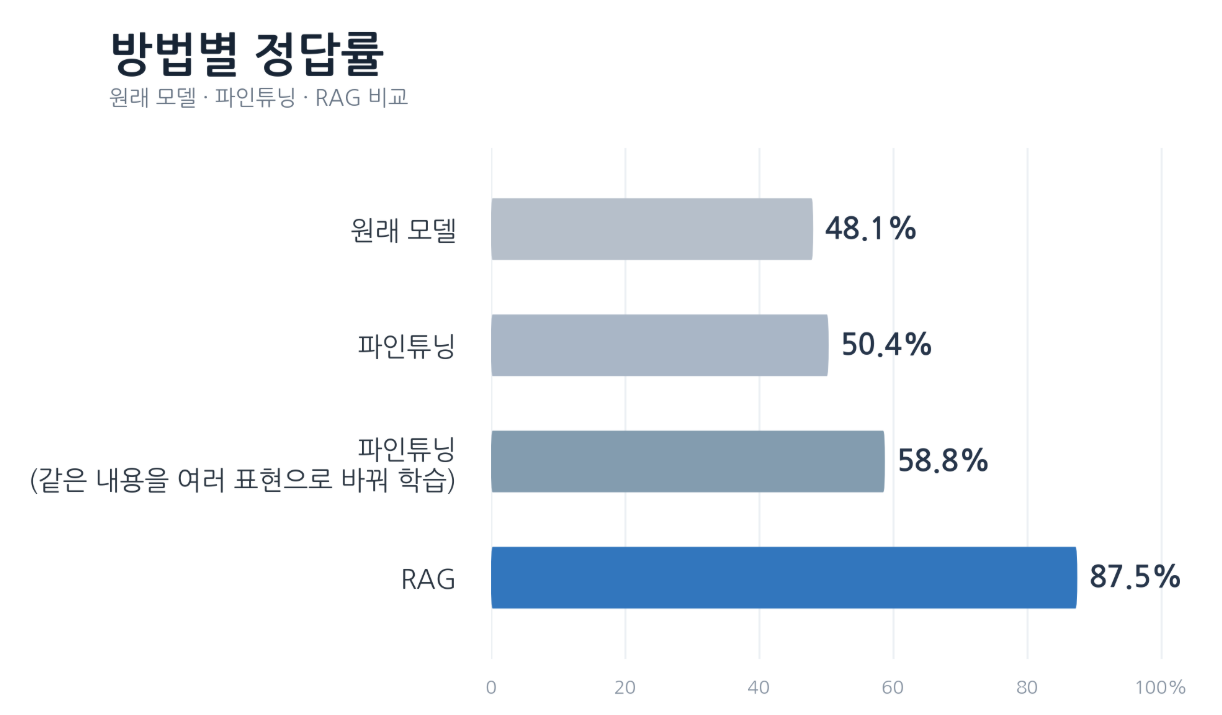
교과서를 펼쳐 본 학생이 압도적이었습니다.
다만 이 실험에서는 문제와 검색 자료가 일대일로 맞물려 있었습니다. 연구진도 RAG가 좋은 성적을 낸 이유로 이 점을 들었습니다.[4] 필요한 문서를 늘 찾아올 수 있는 건 아니니, 다른 상황에서도 이만큼 차이가 난다고 보기는 어렵습니다.
Llama2 7B는 더 극적이었습니다. 문서를 그대로 학습시켰더니 정답률이 오히려 35.3%에서 21.9%로 떨어졌습니다.[4]
그래프에서 하나 눈여겨볼 막대가 있습니다. 같은 내용을 여러 문장으로 바꿔 가며 학습시키면 파인튜닝 성적이 올랐습니다.
연구진은 모델이 새 지식을 배우려면 그 지식이 여러 방식으로 반복돼야 한다고 봤습니다.[4] 한 번 읽고 외우는 게 아니라, 이렇게도 저렇게도 여러 번 접해야 남는다는 겁니다.
이듬해 구글과 테크니온 공대 연구진은 더 불편한 결과를 내놓았습니다.
이 연구는 1장의 방식대로 질문과 정답을 짝지어 학습시켰습니다. 그런데 모델이 모르던 사실을 이렇게 가르치면, 이미 아는 내용보다 훨씬 느리게 배웠습니다.[5]
게다가 그런 예시를 많이 배울수록, 원래 알던 지식에 대해서도 그럴듯하게 틀리는 경향, 즉 할루시네이션이 그만큼 늘었습니다.[5]
AI가 '그럴듯하게 틀리는' 진짜 이유 (할루시네이션)
AI가 '그럴듯하게 틀리는' 진짜 이유 (할루시네이션)
2023년, 미국 뉴욕의 한 변호사가 법원에 제출한 서면 때문에 미국 법조계가 술렁였습니다.자기 주장을 뒷받침하려고 판례 6건을 인용했는데, 그중 단 한 건도 실제로 존재하지 않았기 때문입니
www.gominq.com
연구진의 결론은 이렇습니다. 모델은 사실 지식을 대부분 처음 학습(사전학습)할 때 얻고, 파인튜닝은 이미 아는 것을 더 잘 쓰는 법을 가르친다는 겁니다.[5]
엄밀히 말하면 두 연구 모두 객관식이나 단답형 질의응답으로 실험했습니다. 긴 글을 쓰거나 복잡한 추론을 하는 일까지 그대로 들어맞는다고 보기는 어렵습니다.
4. 그럼 파인튜닝은 언제 쓰는 걸까?
그런데 파인튜닝을 새 지식을 넣는 데만 쓰는 건 아닙니다.
오히려 강점은 다른 데 있습니다.
OpenAI의 정확도 개선 가이드는 문제를 두 축으로 나눕니다.[3]
하나는 모델에게 주는 자료, 즉 맥락(Context)을 고치는 축입니다. 모델이 학습한 적 없는 지식, 오래된 지식, 회사 내부 정보가 필요할 때입니다.[3] RAG가 여기에 속합니다.
다른 하나는 모델 자체를 고치는 축입니다. 답의 형식이 들쭉날쭉하거나, 말투와 문체가 맞지 않거나, 정해 준 추론 순서를 꾸준히 따르지 못할 때입니다.[3] 파인튜닝이 여기에 속하고요.
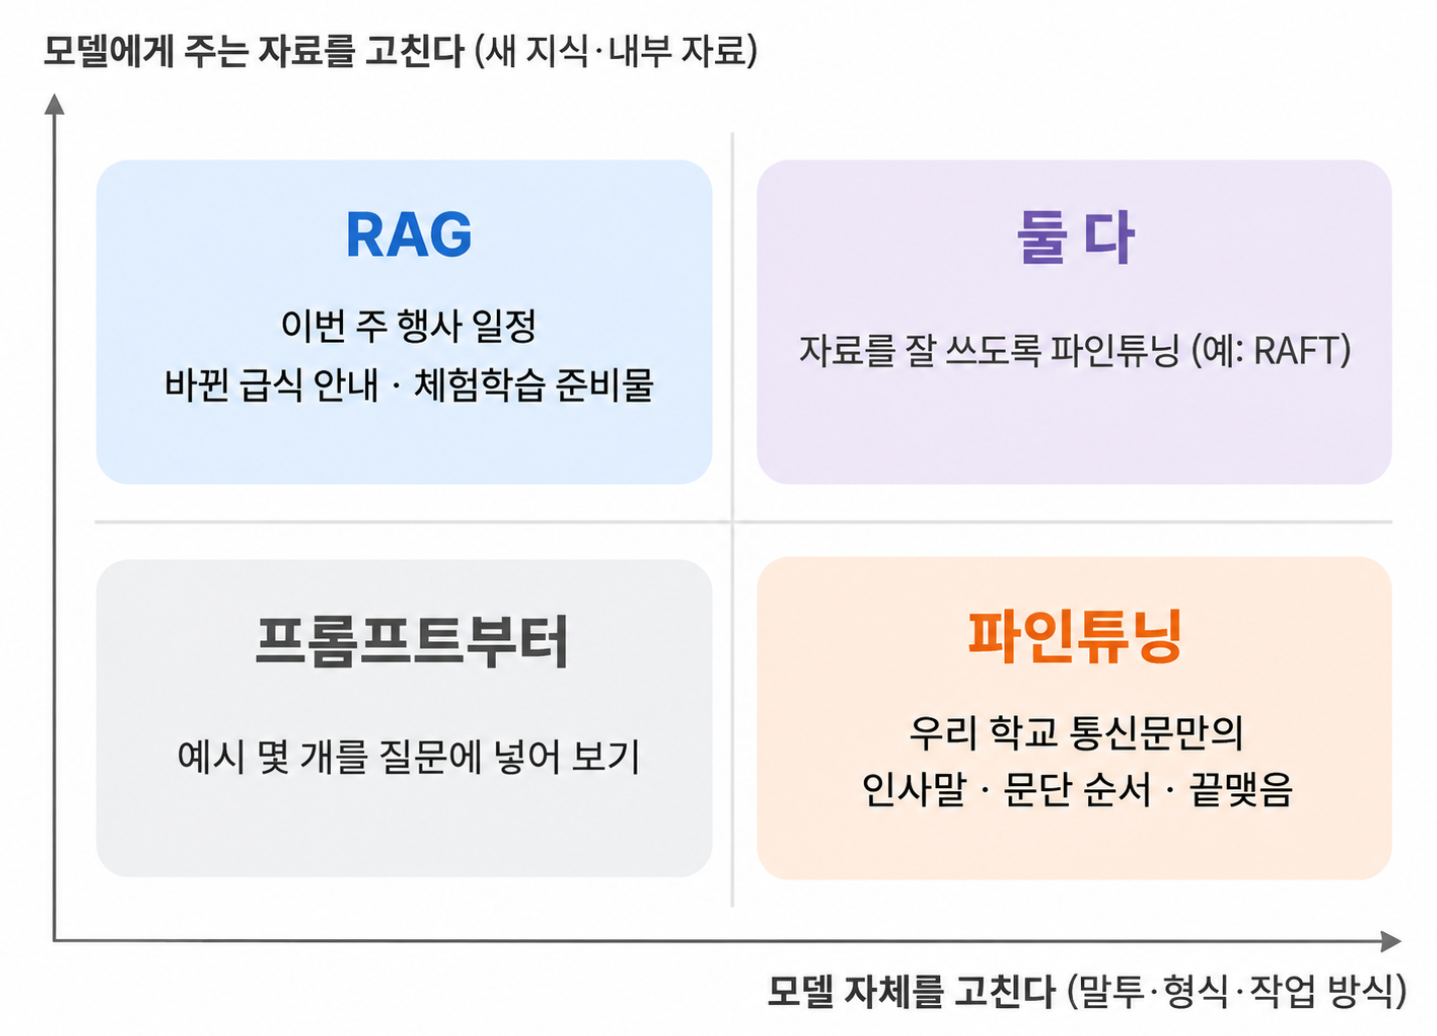
학교에서 가정통신문 초안을 쓰는 AI를 만든다고 해 보겠습니다.
이번 주 행사 일정, 바뀐 급식 안내, 현장체험학습 준비물은 매주 바뀝니다. 이런 내용을 파인튜닝으로 넣으면 주마다 다시 학습시켜야 합니다. 학사 일정표와 공문을 문서로 두고 RAG로 찾아 쓰는 편이 맞습니다.
반대로 우리 학교 통신문만의 인사말, 문단 순서, 끝맺음 같은 건 잘 바뀌지 않습니다. 지난 통신문 수십 장으로 이 형식을 익히게 하는 건 파인튜닝이 잘하는 일입니다.
물론 말투나 형식도 프롬프트에 예시 몇 개를 넣는 것만으로 해결되는 경우가 많습니다. OpenAI 가이드도 프롬프트부터 시작해서, 부족한 부분이 지식인지 행동인지 따져 본 뒤 다음 방법을 고르라고 합니다.[3]
5. 자료를 찾아와도 틀릴 수 있다
그렇다고 문서를 옆에 두기만 하면 끝나는 것도 아닙니다.
2022년 11월, 캐나다의 제이크 모펫(Jake Moffatt)은 할머니의 장례식에 가려고 에어캐나다 웹사이트의 챗봇에게 유가족 할인 요금을 물었습니다.[6]
챗봇은 이미 여행을 다녀왔더라도 항공권을 산 날로부터 90일 안에 신청하면 할인을 받을 수 있다고 답했습니다.[6]
틀린 답이었습니다. 그런데 더 어이없는 건, 챗봇이 답변에 달아 준 링크였습니다. 바로 그 페이지에 여행을 마친 뒤에는 할인이 적용되지 않는다고 적혀 있었거든요.[6]
2024년 2월, 캐나다 브리티시컬럼비아주의 민사분쟁조정 재판소는 챗봇이 준 잘못된 정보에 대해 에어캐나다가 책임져야 한다고 판단했습니다.[7]
이 챗봇이 어떤 방식으로 만들어졌는지는 공개되지 않았습니다. 그래도 바른 문서를 가지고 있는 것과 그 문서를 제대로 읽고 답하는 것은 다른 문제라는 걸 잘 보여 줍니다.
RAG에서도 같은 일이 생길 수 있습니다. 엉뚱한 문서를 찾아오거나, 관련 없는 문서가 섞이거나, 문서를 가져와도 모델이 제대로 읽지 않으면 틀린 답이 나옵니다.
파인튜닝과 RAG를 그냥 합친다고 해결되는 것도 아닙니다. 앞의 마이크로소프트 실험에서 파인튜닝한 모델에 RAG를 붙였더니, Mistral 7B의 정답률이 81.0%로 RAG만 쓴 87.5%보다 낮았습니다.[4]
2024년 UC 버클리 연구진은 이 문제를 다시 시험에 빗댔습니다. 지금의 RAG는 공부는 안 하고 오픈북 시험을 보는 것과 같다는 겁니다.[8]
그래서 내놓은 방법이 RAFT입니다. 질문과 함께 문서 여러 개를 주고, 그중 답에 도움이 안 되는 문서는 무시하도록 파인튜닝합니다.[8] 오픈북 시험에 맞게, 교과서 찾아보는 법을 미리 연습시키는 셈이죠.
연구진은 이 방식이 PubMed, HotpotQA, Gorilla 같은 여러 데이터셋에서 꾸준히 성능을 높였다고 밝혔습니다.[8]
6. 정리
새 지식이나 자주 바뀌는 정보는 RAG가, 말투와 형식처럼 일하는 방식은 파인튜닝이 더 잘 맞습니다.
OpenAI가 파인튜닝 플랫폼을 접는다고 파인튜닝이라는 기술이 사라지는 건 아닙니다. 앞의 마이크로소프트 실험처럼 공개된 모델을 직접 학습시키는 길은 그대로이고, RAFT처럼 둘을 섞는 연구도 계속 나오고 있습니다.
참고문헌
[1] OpenAI, Introducing improvements to the fine-tuning API and expanding our custom models program (2026년 5월 8일 업데이트 공지)
[2] OpenAI Docs, Supervised fine-tuning
[3] OpenAI Docs, Optimizing LLM Accuracy
[4] Ovadia et al., Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs (EMNLP 2024)
[5] Gekhman et al., Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? (EMNLP 2024)
[6] Moffatt v. Air Canada, 2024 BCCRT 149 (2024년 2월 14일 판결), https://decisions.civilresolutionbc.ca/crt/crtd/en/525448/1/document.do
[8] Zhang et al., RAFT: Adapting Language Model to Domain Specific RAG (2024)
태그: AI, AI용어, AI리터러시, 파인튜닝, FineTuning, RAG, LLM, 할루시네이션, 인공지능
'IT > AI_용어' 카테고리의 다른 글
| [AI][용어] AI 에이전트(Agent)란? 챗봇과 무엇이 다른가 (0) | 2026.11.17 |
|---|---|
| [AI][용어] 파라미터(Parameter)란? 'AI가 70B'라고 할 때 그 B의 정체 (0) | 2026.08.09 |
| [AI][용어] 임베딩(Embedding)이란? AI가 단어를 '숫자'로 이해하는 법 (0) | 2026.06.28 |
| [AI][용어] 크로스 엔트로피란? AI가 얼마나 틀렸는지 재는 법 (0) | 2026.06.22 |
| [AI][용어] AI Temperature란? ChatGPT 답변이 달라지는 이유 (0) | 2026.06.19 |